

Ở Bài 9, chúng ta đã khai thác Mục 4b1 để xây dựng các biến phản ánh hoạt động sản xuất nông nghiệp của hộ như diện tích canh tác, sản lượng lúa và các loại cây trồng, phân bón và các khoản chi phí sản xuất. Bài 10 tiếp tục từ bước xây dựng dữ liệu sang ước lượng các mô hình kinh tế lượng, với hộ sản xuất lúa làm đơn vị phân tích. Câu hỏi trung tâm là: sản lượng lúa có quan hệ như thế nào với các đầu vào sản xuất, và các hộ sử dụng những đầu vào đó hiệu quả đến mức nào? Để trả lời, bài thực hành này lần lượt sử dụng hàm sản xuất Cobb-Douglas, hàm Translog và Stochastic Frontier Analysis (SFA). Qua đó, sinh viên và nhà nghiên cứu không chỉ thực hành các lệnh Stata mà còn tìm hiểu cách lựa chọn các biến đại diện thích hợp với dữ liệu sẵn có, lựa chọn dạng hàm sản xuất, ước lượng độ co giãn và hiệu suất theo quy mô, đồng thời tách yếu tố nhiễu ngẫu nhiên khỏi phi hiệu quả để ước lượng hiệu quả kỹ thuật (TE) của từng hộ sản xuất lúa.
1. Mục tiêu và logic của bài thực hành
Bài thực hành xây dựng các hàm sản xuất lúa ở cấp hộ từ VHLSS 2020. Trọng tâm là lựa chọn các biến output và inputs phù hợp với cấu trúc dữ liệu, sau đó lần lượt ước lượng hàm Cobb-Douglas, Translog và Stochastic Frontier. Người học cần phân biệt ba câu hỏi: (i) các yếu tố đầu vào liên hệ với sản lượng như thế nào; (ii) dạng hàm Cobb-Douglas có quá hạn chế hay không; và (iii) sau khi tách yếu tố nhiễu ngẫu nhiên khỏi phần phi hiệu quả kỹ thuật, thì trung bình các hộ nằm cách đường giới hạn sản xuất (production frontier) bao xa và nguyên nhân là gì. Cần lưu ý rằng, một số nhân tố khác có thể ảnh hưởng đến mức độ (phi) hiệu quả kỹ thuật chưa được đưa vào mô hình do chúng ta vẫn chưa khai thác hết thông tin phần sau của bộ dữ liệu VHLSS 2020.
2. Đơn vị phân tích và các nguồn dữ liệu
Đơn vị phân tích cuối cùng là hộ có sản xuất lúa. Dữ liệu được ghép từ các tệp đã xử lý ở Bài 9 và từ Mục 1A–Mục 2. Các tệp gốc có thể có đơn vị quan sát khác nhau, chẳng hạn mùa vụ lúa, loại chi phí hoặc loại phân bón; vì vậy phải tổng hợp về cấp hộ trước khi sử dụng lệnh merge.

3. Lựa chọn output và các production inputs
Việc chọn biến bắt đầu từ khái niệm hàm sản xuất (bạn nên tham khảo tài liệu học thuật và trích dẫn), khả năng đo lường của VHLSS và mức độ mất quan sát. Dạng mô hình chính của bài là:
Yᵢ = f(Landᵢ, Fertᵢ, Pesticideᵢ, OtherCostᵢ; HiredLaborᵢ)
Tôi đã thử Energy cost, nhưng không có quan sát nào trong mẫu các hộ sản xuất lúa có thông tin về loại chi phí này. Hơn nữa, trong VHLSS 2020 cũng không có thông tin về tổng số giờ (ngày) lao động. Chính vì vậy tôi sử dụng chi phí thuê lao động làm biến đại diện. Tuy nhiên, chỉ có khoảng 110 quan sát có giá trị chi phí thuê lao động, nên nếu giữ biến này thì bị mất quá nhiều bậc tự do. Giải pháp tôi đưa ra là sử dụng kỹ thuật biến giả (dummy variable) cho chi phí thuê lao động.
Trong đó Y là sản lượng lúa; Land (diện tích đất), Fert (phân bón), Pesticide (thuốc), và OtherCost (chi phí khác) là các đầu vào liên tục; HiredLabor là biến giả bổ sung phản ánh hộ có phát sinh thuê lao động.
3.1. Biến phụ thuộc: sản lượng lúa
Biến phụ thuộc là rice_output, đo bằng kg. Bài sử dụng sản lượng vật chất thay vì doanh thu hay giá trị sản xuất để mô hình tập trung vào quan hệ kỹ thuật giữa các đầu vào và lượng lúa thu hoạch cả năm, hạn chế việc giá bán đi trực tiếp vào biến phụ thuộc.
Yᵢ = rice_outputᵢ (kg)
3.2. Land
Biến rice_area_ha là tổng diện tích gieo trồng lúa tính bằng ha. Đây là đầu vào quy mô cơ bản của sản xuất nông nghiệp và được giữ dưới dạng biến liên tục.
Landᵢ = rice_area_haᵢ
3.3. Fertilizer
Biến fert_rice là tổng lượng phân bón sử dụng cho lúa tính bằng kg và là biến liên tục. Hàm sản xuất sử dụng lượng vật chất thay vì chi phí phân bón (fertcost_rice). Biến chi phí vẫn được giữ để phân rã tổng chi phí, nhưng không dùng thay cho fert_rice trong hàm sản xuất.
Fertᵢ = fert_riceᵢ (kg)
3.4. Pesticide
Khác với phân bón có thể tổng hợp tương đối phù hợp theo kg, thuốc bảo vệ thực vật gồm nhiều loại với đơn vị, nồng độ và công dụng khác nhau nên khó xây dựng một thước đo số lượng chung. Vì vậy, pesticide_rice được đo bằng chi phí sử dụng thuốc bảo vệ thực vật và được xem như một biến đại diện đầu vào bằng tiền trong hàm sản xuất. Đây cũng là biến liên tục.
3.5. Vì sao bỏ Energy cost?
Dạng hàm Cobb-Douglas ban đầu dự kiến gồm Land, Fertilizer, Pesticide, Labor, Energy và Other cost. Tuy nhiên, kiểm tra dữ liệu cho thấy không có hộ nào có thông tin về Energy cost, nên biến này không thể được sử dụng để ước lượng mô hình. Vì vậy, Energy được loại khỏi các hàm sản xuất trong bài thực hành này.
3.6. Vì sao không dùng Labor cost như một đầu vào liên tục?
Biến laborcost_rice phản ánh chi phí lao động thuê, không phản ánh tổng lao động sử dụng trong sản xuất lúa. Nhiều hộ sử dụng lao động gia đình nhưng không có chi phí lao động thuê dương. Khi tạo ln_labor từ laborcost_rice, chỉ còn một nhóm rất nhỏ hộ có giá trị dương (khoảng 110); nếu đưa ln_labor vào mô hình ước lượng, thì cỡ mẫu giảm từ khoảng 2,700 xuống chỉ khoảng hơn một trăm quan sát.
Do đó bài không coi laborcost_rice là đại diện cho tổng labor input. Thay vào đó, hired_labor được dùng như một dummy để phân biệt hộ có và không phát sinh thuê lao động. ln_labor vẫn có thể được tạo để kiểm tra robustness trên subsample phù hợp, nhưng không phải input của mô hình chính.
HiredLaborᵢ = 1 nếu hộ có chi phí lao động thuê > 0; 0 nếu không
3.7. Other cost
OtherCost được xây dựng từ tổng chi phí sau khi loại các khoản đã được biểu diễn riêng trong mô hình hoặc trong cấu trúc chi phí:
OtherCostᵢ = TotalCostᵢ − FertilizerCostᵢ − PesticideCostᵢ − HiredLaborCostᵢ
Cách làm này tránh tính trùng chi phí. Đặc biệt, fert_rice được đo bằng kg nhưng fertcost_rice được đo bằng tiền; khi phân rã tổng chi phí phải dùng fertcost_rice, không được trừ fert_rice khỏi một đại lượng tiền tệ.
4. Tạo biến log và xác định mẫu ước lượng
Các mô hình sử dụng log của các biến output và bốn inputs liên tục. Chỉ giá trị dương mới có log xác định. Do đó sample_main đồng thời là một quyết định về dữ liệu và về dạng mô hình.
gen ln_y = ln(rice_output) if rice_output>0
gen ln_land = ln(rice_area_ha) if rice_area_ha>0
gen ln_fert = ln(fert_rice) if fert_rice>0
gen ln_pesticide = ln(pesticide_rice) if pesticide_rice>0
gen ln_other = ln(othercost_rice) if othercost_rice>0
gen sample_main = ///
ln_y<. & ln_land<. & ln_fert<. & ///
ln_pesticide<. & ln_other<. & hired_labor<.
Trong Stata, với biến số, điều kiện x < . có nghĩa là x không bị missing.
Cụ thể:
- sample_main = 1: hộ có đầy đủ dữ liệu về ln_y, ln_land, ln_fert, ln_pesticide, ln_other và hired_labor.
- sample_main = 0: hộ thiếu ít nhất một trong các biến trên.
Dấu & nghĩa là AND – đồng thời thỏa mãn tất cả điều kiện.
Dùng cùng sample_main cho Cobb-Douglas và Translog giúp việc so sánh dạng hàm không bị lẫn với thay đổi thành phần mẫu.
5. Mô hình 1 – Hàm Cobb-Douglas với OLS
Mô hình kinh tế lượng được viết đầy đủ như sau:
ln(Yᵢ) = β₀ + β₁ln(Landᵢ) + β₂ln(Fertᵢ) + β₃ln(Pesticideᵢ) + β₄ln(OtherCostᵢ) + δHiredLaborᵢ + εᵢ
Yᵢ là tổng sản lượng lúa của hộ i. Landᵢ, Fertᵢ, Pesticideᵢ và OtherCostᵢ là bốn đầu ào sản xuất liên tục. HiredLaborᵢ là dummy variable. εᵢ là phần sai số tổng hợp chưa được mô hình giải thích (hạng nhiễu ngẫu nhiên).
reg ln_y ///
ln_land ln_fert ln_pesticide ln_other hired_labor ///
if sample_main==1, vce(robust)
Trong Cobb-Douglas dạng log-log (log kép), β₁ đến β₄ là các hệ số co giãn (output elasticities). Ví dụ β₁ cho biết phần trăm thay đổi kỳ vọng của sản lượng khi diện tích tăng 1%, giữ các yếu tố khác không đổi.
RTS = β₁ + β₂ + β₃ + β₄
RTS = 1 là constant returns to scale (hiệu suất không đổi theo quy mô); RTS > 1 là increasing returns to scale (hiệu suất tăng theo quy mô); RTS < 1 là decreasing returns to scale (hiệu suất giảm theo quy mô). HiredLabor không được cộng vào RTS vì δ không phải là hệ số co giãn của một đầu vào liên tục. Hệ số này phản ánh semi-elasticity:
%ΔY do HiredLabor = 100 × [exp(δ) − 1]
Kết quả ước lượng mô hình CD:
reg ln_y ln_land ln_fert ln_pesticide ln_other ///
hired_labor ///
if sample_main==1, ///
vce(robust)

Kiểm định xem 4 biến đầu vào liên tục có đồng thời ảnh hưởng sản lượng lúa:
estimates store cd_main
lincom ///
_b[ln_land] + ///
_b[ln_fert] + ///
_b[ln_pesticide] + ///
_b[ln_other]

Kết quả: t-stat = 226.54 (rất lớn) và p-value = 0.000 (rất nhỏ): Ta bác bỏ giả thuyết Ho cho rằng 4 biến này đồng thồng không ảnh hưởng log(output).
Kiểm định giả thuyết RTS:
test ///
_b[ln_land] + ///
_b[ln_fert] + ///
_b[ln_pesticide] + ///
_b[ln_other] = 1

Kết quả kiểm định bác bỏ . Do tổng độ co giãn của các đầu vào lớn hơn 1, có thể kết luận các hộ sản xuất lúa trong mẫu có hiệu suất tăng theo quy mô (increasing returns to scale).
6. Mô hình 2 – Hàm Translog với OLS
Cobb-Douglas giả định các hệ số co giãn (elasticities) có cấu trúc cố định và không cho phép nhiều dạng tương tác linh hoạt giữa các nhập lượng. Hàm Translog mở rộng Cobb-Douglas bằng cách đưa thêm các biến bình phương (squared terms) và tương tác cặp (pairwise interactions) vào mô hình. Mô hình có dạng như sau:

Với X = {Land, Fert, Pesticide, OtherCost}, mô hình có 4 số hạng tuyến tính (linear terms), 4 số hạng bình phương (squared terms) và 6 số hạng tương tắc cặp (pairwise interaction terms). Cobb-Douglas là trường hợp đặc biệt khi toàn bộ các hệ số của biến bình phương và tương tác đồng thời bằng 0. Nghĩa là:

Do đó cần dùng kiểm định giả thuyết đồng thời (joint test) thay vì quyết định dạng hàm chỉ bằng dựa vào giá trị xác suất p-value của từng hệ số ước lượng. Nếu bác bỏ H₀, dữ liệu không ủng hộ các ràng buộc tuyến tính của mô hình Cobb-Douglas.
Kết quả ước lượng:

Sử dụng lệnh testparm, ta có:

Với giá trị xác suất rất thấp (0.0000) ta có thể kết luận rằng mô hình Tranlog phù hợp với dữ liệu hơn so với mô hình Cobb-Douglas.
7. Mô hình 3 – Stochastic Frontier Analysis
7.1. Tại sao OLS chưa đủ cho câu hỏi về efficiency?
Trong OLS, mọi chênh lệch giữa output quan sát và output dự báo đều nằm trong một sai số εᵢ. Nếu mục tiêu là hiệu quả kỹ thuật (technical efficiency), ta cần phân biệt chênh lệch do các cú sốc ngẫu nhiên với chênh lệch do hộ hoạt động dưới đường giới hạn khả năng sản xuất (production frontier). Mô hình này có dạng tổng quát như sau:
ln(Yᵢ) = f(Xᵢ; β) + vᵢ − uᵢ
Ở đây, vᵢ là nhiễu ngẫu nhiên hai phía (two-sided random noise), được giả định có phân phối chuẩn; uᵢ ≥ 0 là mức phi hiệu quả kỹ thuật một phía (one-sided technical inefficiency). Vì uᵢ được trừ khỏi mức giới hạn sản lượng (f(Xᵢ; β)), nên uᵢ càng lớn thì sản lượng thực tế của hộ càng nằm xa biên giới hạn khả năng sản xuất. Như vậy,
vᵢ ~ N(0, σᵥ²)
uᵢ ≥ 0
TEᵢ = exp(−uᵢ), 0 < TEᵢ ≤ 1
7.2. Vì sao dùng phân phối Normal–Exponential trong bài này?
Cần phân biệt hai thành phần phân phối. Random noise vᵢ vẫn là phân phối chuẩn (Normal). Lựa chọn phân phối mũ (Exponential) áp dụng cho thành phần phi hiệu quả uᵢ. Vì vậy dạng hàm của mô hình này có thể được gọi ngắn gọn là Normal–Exponential frontier. Nghĩa là,
vᵢ ~ N(0, σᵥ²)
uᵢ ~ Exponential
Ban đầu, tôi đã thử half-normal cho uᵢ — lựa chọn mặc định thường gặp, trong đó uᵢ là phần dương của một phân phối chuẩn tâm tại 0. Tuy nhiên với dữ liệu đang sử dụng, Stata báo initial values not feasible; ngay cả với dạng mô hình rất đơn giản chỉ có Land hoặc Land và Fertilizer cũng không hội tụ từ giá trị khởi đầu khả thi.
Khi chuyển sang phân phối mũ (exponential distribution) cho uᵢ, mô hình hội tụ ổn định. Vì vậy bài sử dụng Normal–Exponential để tiếp tục phân tích. Đây là lựa chọn thực nghiệm phù hợp với bộ dữ liệu hiện tại, không phải kết luận rằng phân phối exponential luôn tốt hơn phân phối half-normal. Tiếp theo sẽ là các kết quả ước lượng các mô hình Frontier.
8. Cobb-Douglas Stochastic Frontier
Dạng hàm như sau:
ln(Yᵢ) = β₀ + β₁ln(Landᵢ) + β₂ln(Fertᵢ) + β₃ln(Pesticideᵢ) + β₄ln(OtherCostᵢ) + δHiredLaborᵢ + vᵢ − uᵢ
Mô hình này cũng gồm các biến giống như Cobb-Douglas ước lượng theo phương pháp OLS nhưng thay εᵢ bằng vᵢ − uᵢ. Nhờ đó có thể dự báo TE cho từng hộ. Ước lượng trên Stata bằng lệnh:
frontier ln_y ///
ln_land ln_fert ln_pesticide ln_other hired_labor ///
if sample_main==1, ///
distribution(exponential)
predict te_cd if e(sample), te
Kết quả ước lượng:
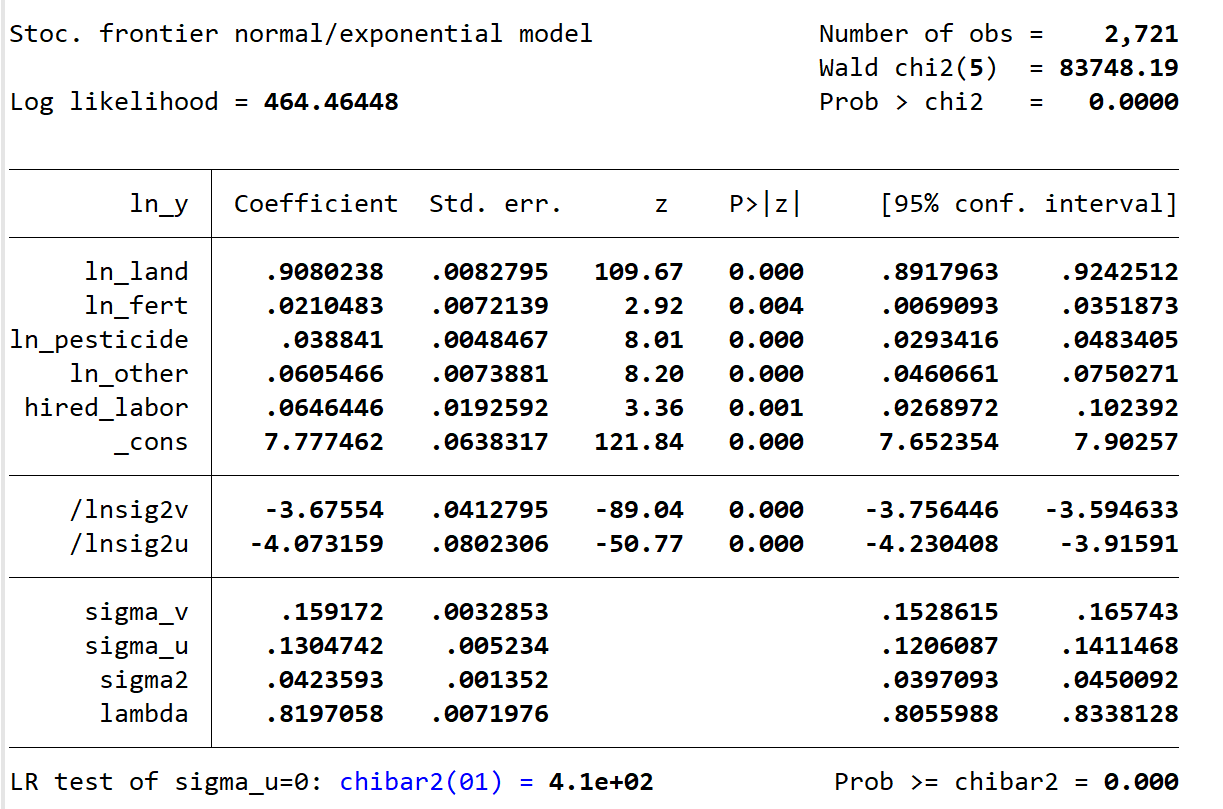
Do Prob >= chibar2 = 0.000 < 0.05, ta bác bỏ:

Vì vậy kết luận có bằng chứng về sự tồn tại của phi hiệu quả kỹ thuật, nghĩa là khi mục tiêu nghiên cứu là đo lường (phi) hiệu quả kỹ thuật, thì việc sử dụng Stochastic Frontier là phù hợp.
Phân phối hiệu quả kỹ thuật từ mô hình CD-SFA:

So sánh CD-OLS với CD-SFA:

9. Translog Stochastic Frontier
Dạng hàm như sau:
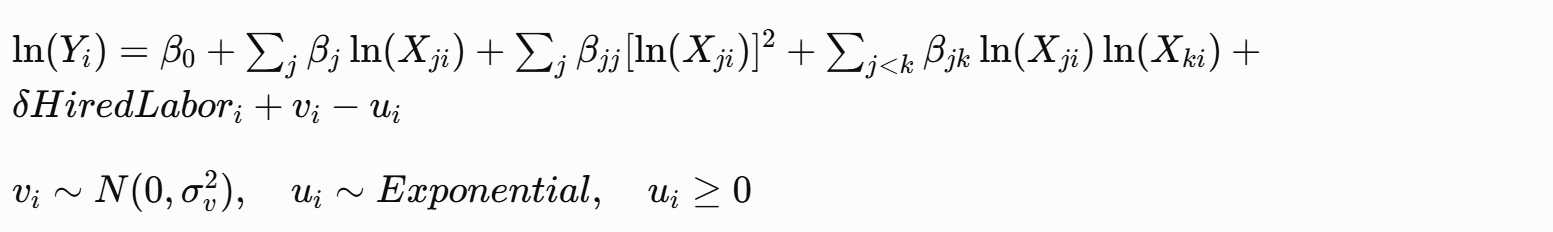
Ước lượng trên Stata:
frontier ln_y c.ln_land##c.ln_land c.ln_fert##c.ln_fert c.ln_pesticide##c.ln_pesticide ///
c.ln_other##c.ln_other c.ln_land#c.ln_fert c.ln_land#c.ln_pesticide ///
c.ln_land#c.ln_other c.ln_fert#c.ln_pesticide c.ln_fert#c.ln_other ///
c.ln_pesticide#c.ln_other hired_labor ///
if sample_main==1, distribution(exponential)
estimates store sfa_tl
Kết quả ước lượng:

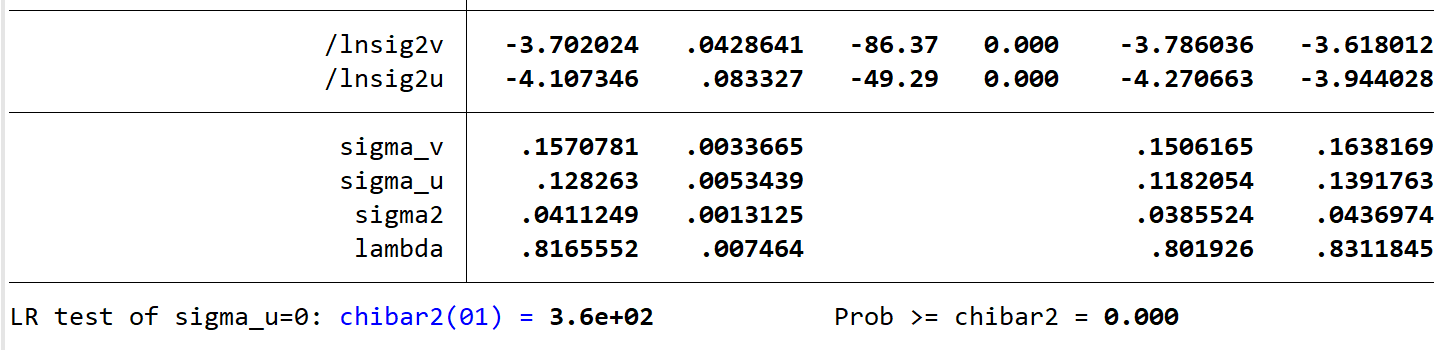
Do Prob >= chibar2 = 0.000 < 0.05, ta bác bỏ:
Vì vậy kết luận có bằng chứng về sự tồn tại của phi hiệu quả kỹ thuật, nghĩa là khi mục tiêu nghiên cứu là đo lường (phi) hiệu quả kỹ thuật, thì việc sử dụng Stochastic Frontier là phù hợp.
Phân phối hiệu quả kỹ thuật:
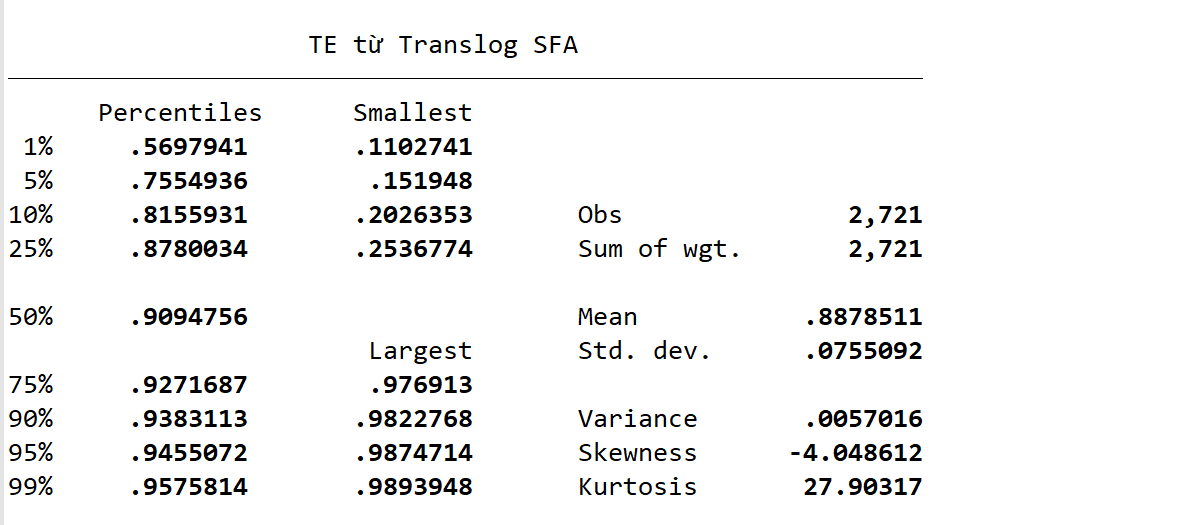
So sánh Tranlog_OLS với Tranlog_SFA:

10. Translog SFA mở rộng
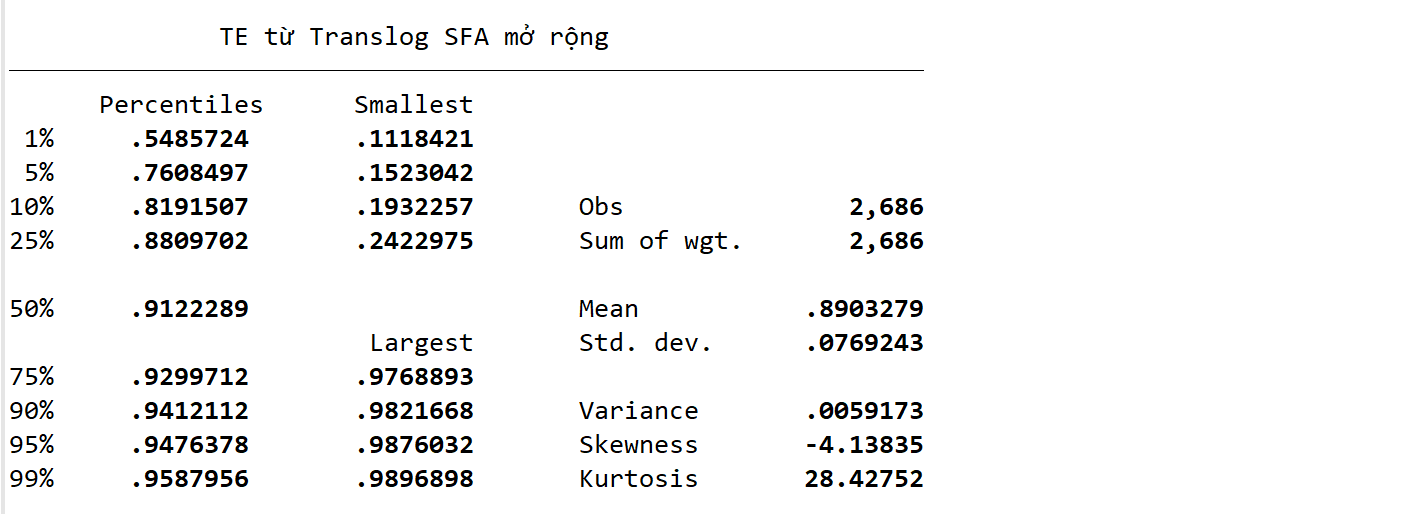
Bước mở rộng cho phép mức độ phân tán của technical inefficiency thay đổi theo các đặc điểm hộ. Các biến Z trong do-file là tuổi chủ hộ, giới tính chủ hộ, quy mô hộ, lớp phổ thông cao nhất đã hoàn thành và sử dụng phân hữu cơ.
Dạng hàm:
ln(Yᵢ) = fTranslog(Xᵢ; β) + δHiredLaborᵢ + vᵢ − uᵢ
Var(uᵢ | Zᵢ) = g(AgeHeadᵢ, FemaleHeadᵢ, HHSizeᵢ, SchoolGradeᵢ, OrganicFertᵢ)
Lưu ý: Trong Stata, uhet() mô hình hóa heteroskedasticity của thành phần phi hiệu quả. Vì vậy, hệ số của các biến Z trong uhet() không phải là hệ số co giãn, không biểu thị phần trăm thay đổi của Technical Efficiency (TE) và không nên được diễn giải trực tiếp như các hệ số trong một phương trình phi hiệu quả trung bình (mean-inefficiency equation). Dấu và mức ý nghĩa thống kê của các hệ số cho biết các biến Z có liên quan như thế nào đến mức độ phân tán của thành phần phi hiệu quả, chứ không trực tiếp cho biết chúng làm tăng hay giảm TE.
Thực hiện trên Stata:
frontier ln_y c.ln_land##c.ln_land c.ln_fert##c.ln_fert c.ln_pesticide##c.ln_pesticide ///
c.ln_other##c.ln_other c.ln_land#c.ln_fert c.ln_land#c.ln_pesticide ///
c.ln_land#c.ln_other c.ln_fert#c.ln_pesticide c.ln_fert#c.ln_other ///
c.ln_pesticide#c.ln_other hired_labor ///
if sample_sfa_ext==1, distribution(exponential) ///
uhet(age_head female_head hhsize schoolgrade_num use_orgfert_rice)
Kết quả ước lượng:


Phân phối của hiệu quả kỹ thuật:
11. Hệ số co giãn trong mô hình Translog
Do có các số hạng bình phương và tương tác cặp, nên hệ số co giãn của mỗi nhập lượng thay đổi theo tất cả các nhập lượng của từng hộ. Ví dụ với Land:
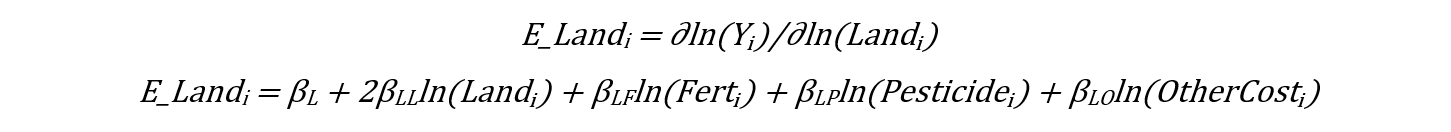
Tương tự, hệ số co giãn của của Fertilizer, Pesticide và OtherCost được tính từ số hạng tuyến tính, bình phương của chính biến đó và tất cả số hạng tương tác có chứa biến đó. Xem do-file để biết các tính hệ số co giãn cho từng hộ. Dưới đây là kết quả:

12. Returns to Scale trong Translog
Công thức:
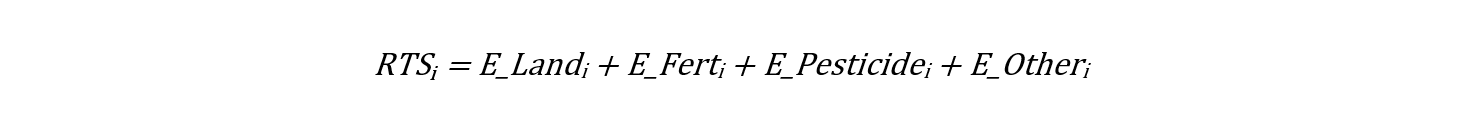
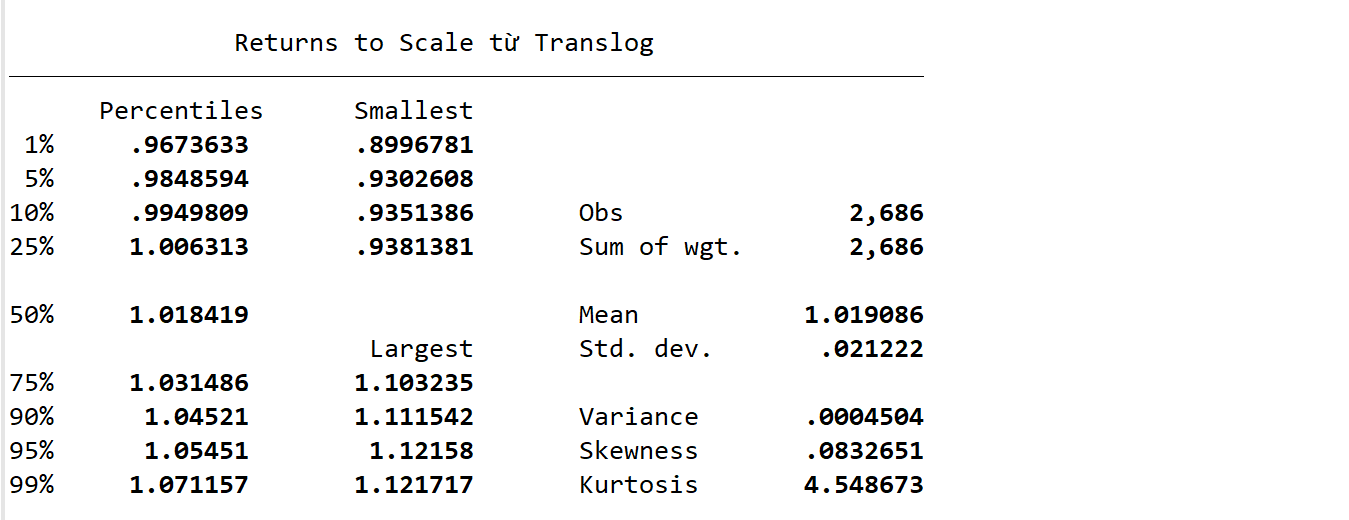
Phân phối RTS từ mô hình Tranlog:
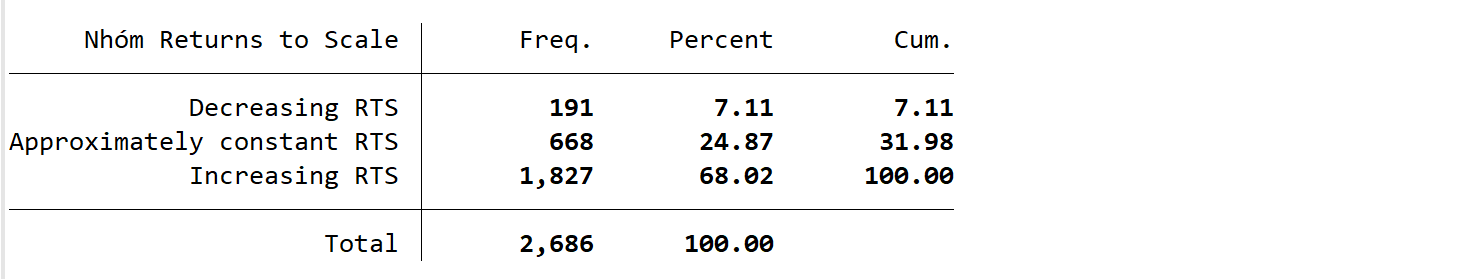
Ta có thể tạo thành các nhóm:
gen rts_group = .
replace rts_group = 1 if rts_tl<0.99 & !missing(rts_tl)
replace rts_group = 2 if inrange(rts_tl,0.99,1.01)
replace rts_group = 3 if rts_tl>1.01 & !missing(rts_tl)
capture label drop rts_lbl
label define rts_lbl ///
1 “Decreasing RTS” ///
2 “Approximately constant RTS” ///
3 “Increasing RTS”
label values rts_group rts_lbl
label var rts_group “Nhóm Returns to Scale”
tab rts_group
13. So sánh hiệu quả kỹ thuật các mô hình SFA
Mô hình Cobb-Douglas Frontier:

Mô hình Tranlog Frontier:

Mô hình Tranlog Frontier mở rộng:

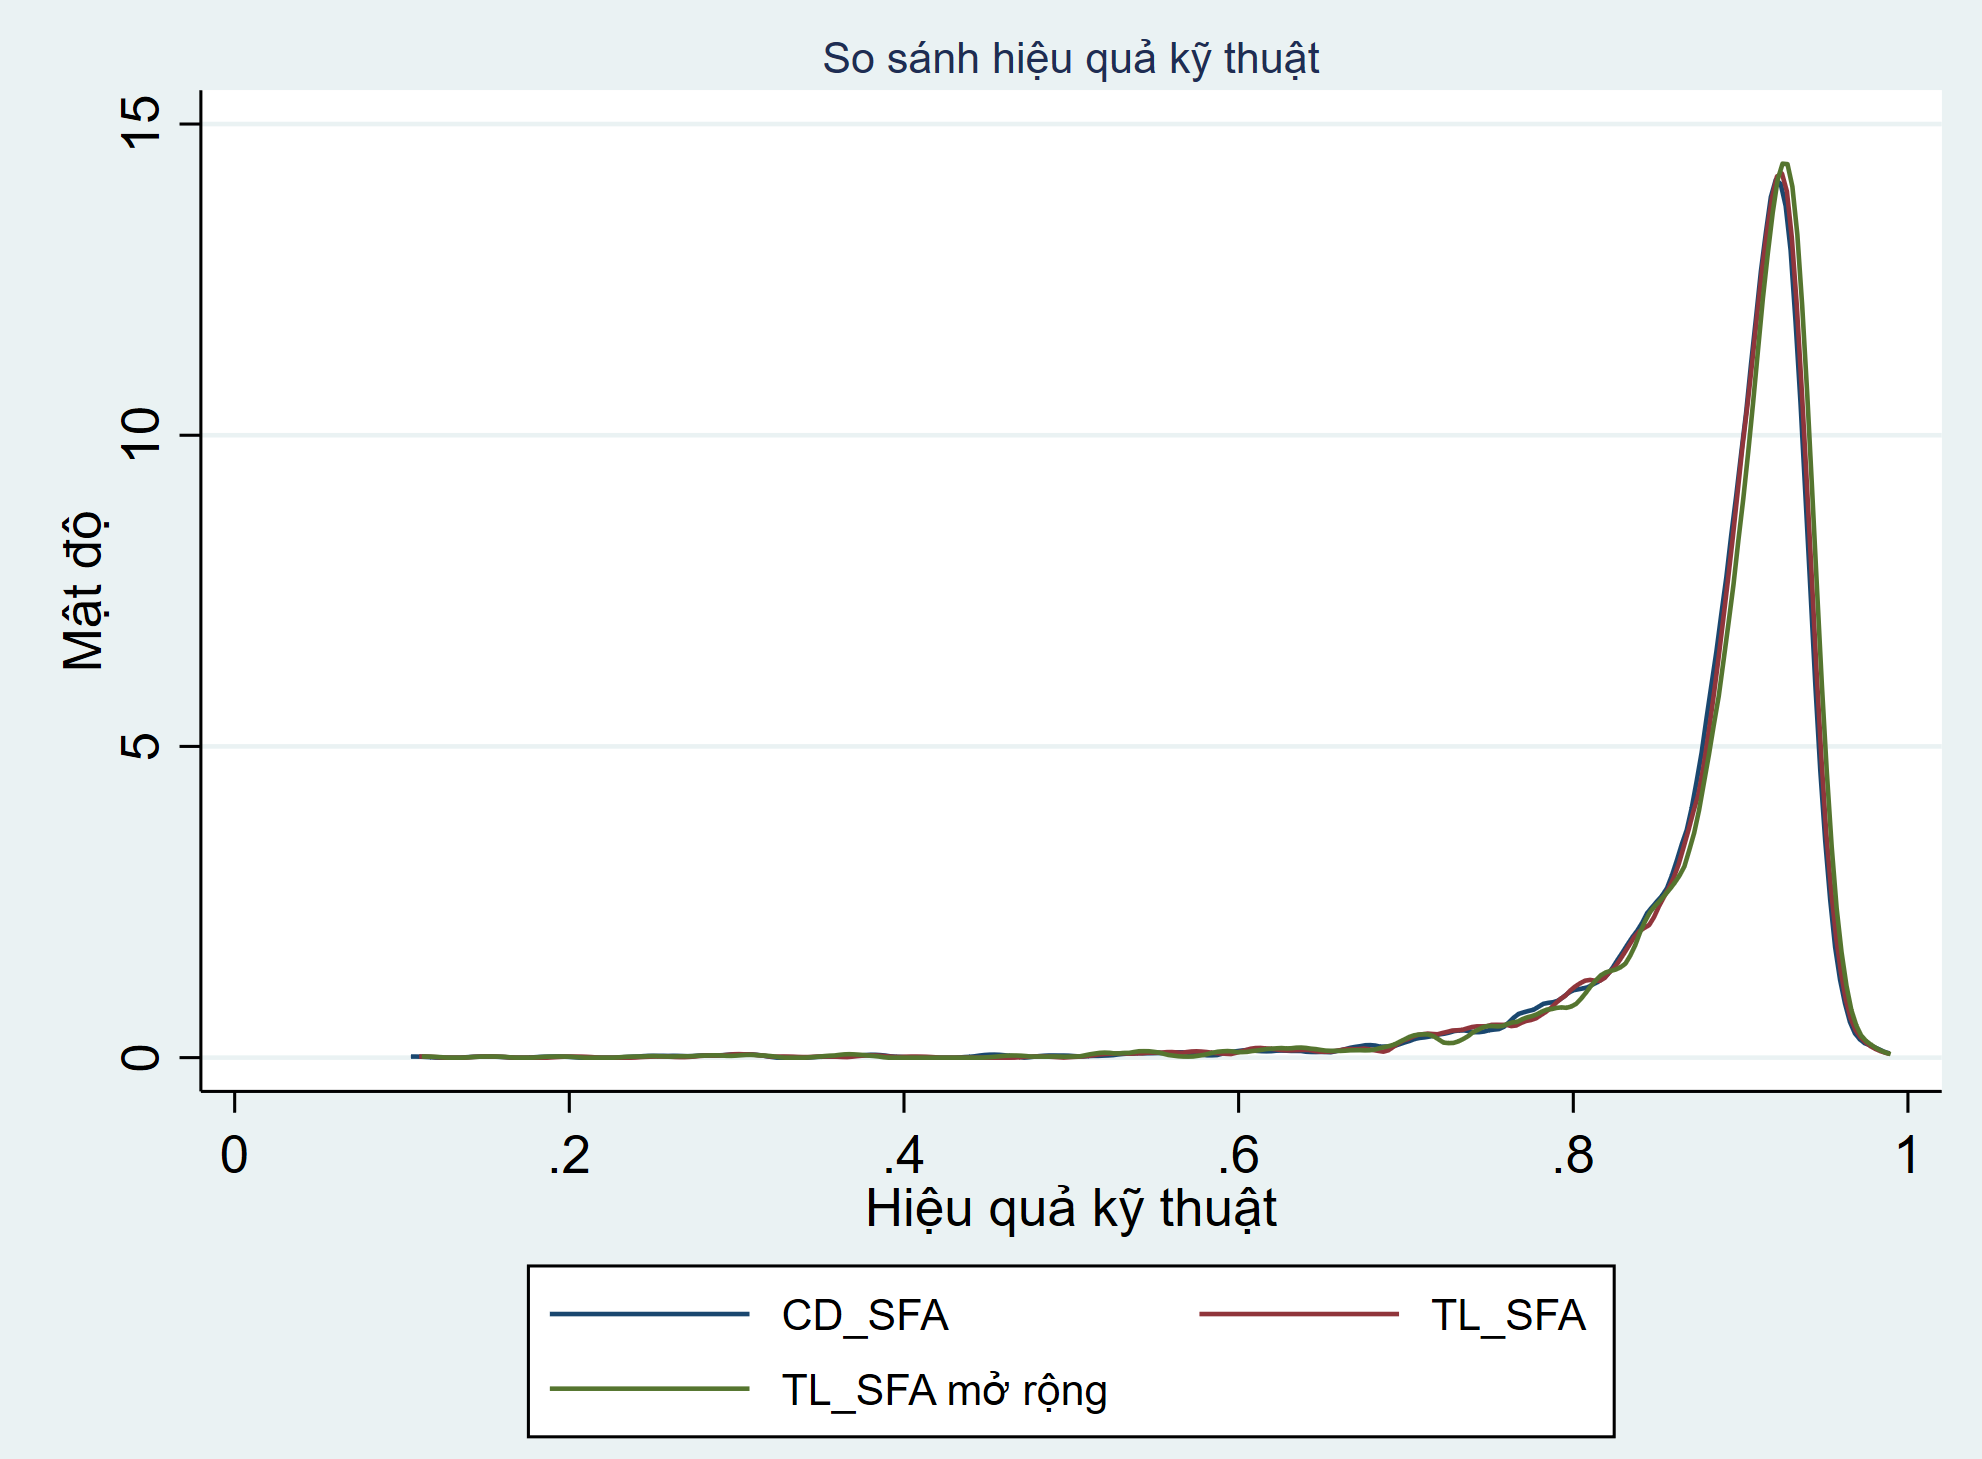
So sánh trên cùng biểu đồ:
Lời kết:
Bài thực hành này bắt đầu từ một câu hỏi kinh tế đơn giản: sản lượng lúa của hộ liên hệ như thế nào với đất, phân bón, thuốc bảo vệ thực vật và các chi phí sản xuất khác? Cobb-Douglas cung cấp một điểm xuất phát dễ diễn giải thông qua các hệ số co giãn và hiệu suất theo quy mô. Translog sau đó nới lỏng cấu trúc của Cobb-Douglas, cho phép tác động của một đầu vào thay đổi theo chính mức đầu vào đó và theo các đầu vào khác. Quá trình lựa chọn biến cũng cho thấy một nguyên tắc quan trọng của nghiên cứu thực nghiệm: mô hình kinh tế lượng phải phù hợp với cách biến được đo lường. Vì vậy Energy cost được loại khi dữ liệu không đủ phù hợp, còn Labor cost không có thông tin tổng ngày/giờ lao động (cả lao động gia đình và thuê) nên ta phải sử dụng biến Hired labor là đại diện. Tuy nhiên, chỉ có 117 quan sát có giá trị dương, nên ta không xem đó là một đầu vào sản xuất, mà chỉ là một nhân tố ảnh hưởng dưới dạng biến giả. Ngoài ra, Stochastic Frontier mở rộng phân tích từ hàm sản xuất sang hiệu quả kỹ thuật bằng cách tách hạng nhiễu ngẫu nhiên khỏi phi hiệu quả kỹ thuật (phân phối một phía). Trong dữ liệu của bài, dạng phân phối Normal–Exponential được sử dụng cho vi và ui vì loại phân phối exponential cho thành phần phi hiệu quả hội tụ ổn định.