

1. Mục tiêu bài học
FAOSTAT là một trong những nguồn dữ liệu quan trọng nhất đối với nghiên cứu nông nghiệp, thực phẩm và hệ thống nông sản. Trước khi sử dụng Stata để tải, làm sạch, ghép và phân tích dữ liệu, người học cần hiểu FAOSTAT cung cấp những loại dữ liệu nào, dữ liệu được tổ chức ra sao, Metadata có ý nghĩa gì và nên lựa chọn dataset như thế nào cho một câu hỏi nghiên cứu.
Sau khi hoàn thành Bài 1, người học có thể:
- giải thích FAOSTAT là gì và vai trò của cơ sở dữ liệu này trong nghiên cứu nông nghiệp và kinh doanh nông nghiệp;
- nhận diện các nhóm dữ liệu chính trên FAOSTAT và lựa chọn nhóm dữ liệu phù hợp với mục tiêu nghiên cứu;
- hiểu cấu trúc cơ bản của một quan sát FAOSTAT thông qua Area, Item, Element, Year, Unit và Value;
- đọc Metadata để hiểu định nghĩa, phạm vi, đơn vị, phương pháp và chất lượng dữ liệu;
- phân biệt Data Explorer, Bulk Downloads và API như các cách khác nhau để truy cập dữ liệu;
- chuẩn bị nền tảng cho Bài 2, trong đó dữ liệu Production sẽ được lấy trực tiếp từ web và xử lý bằng Stata.
2. FAOSTAT là gì?
FAOSTAT là cơ sở dữ liệu thống kê của Tổ chức Lương thực và Nông nghiệp Liên Hợp Quốc (FAO). FAOSTAT cung cấp quyền truy cập miễn phí vào dữ liệu về lương thực và nông nghiệp của hơn 245 quốc gia và vùng lãnh thổ, bao phủ các nhóm khu vực của FAO từ năm 1961 đến năm gần nhất có dữ liệu. Nội dung bao gồm các lĩnh vực như cây trồng, chăn nuôi, lâm nghiệp, thương mại, giá cả, an ninh lương thực, cân đối thực phẩm, sử dụng đất, đầu vào nông nghiệp và phát thải của hệ thống nông thực phẩm.
Góc nhìn Agribusiness. FAOSTAT không chỉ hữu ích để mô tả sản xuất nông nghiệp. Khi kết hợp Production, Trade, Prices, Inputs, Food Balances, Emissions và các nguồn dữ liệu khác, người học có thể xây dựng các bộ dữ liệu phục vụ phân tích thị trường, chuỗi giá trị, năng suất, thương mại và phát triển bền vững.
3. Vì sao FAOSTAT hữu ích cho nghiên cứu?

4. Các nhóm dữ liệu chính trên FAOSTAT
FAOSTAT được tổ chức thành nhiều domain và dataset. Danh mục có thể được FAO cập nhật theo thời gian, nhưng các nhóm dưới đây là những nhóm đặc biệt hữu ích đối với sinh viên và nhà nghiên cứu Kinh doanh nông nghiệp.

Cụ thể như sau (mở xem: FAOSTAT):

Trong mỗi Domain, ta tìm thấy các mục con như sau:
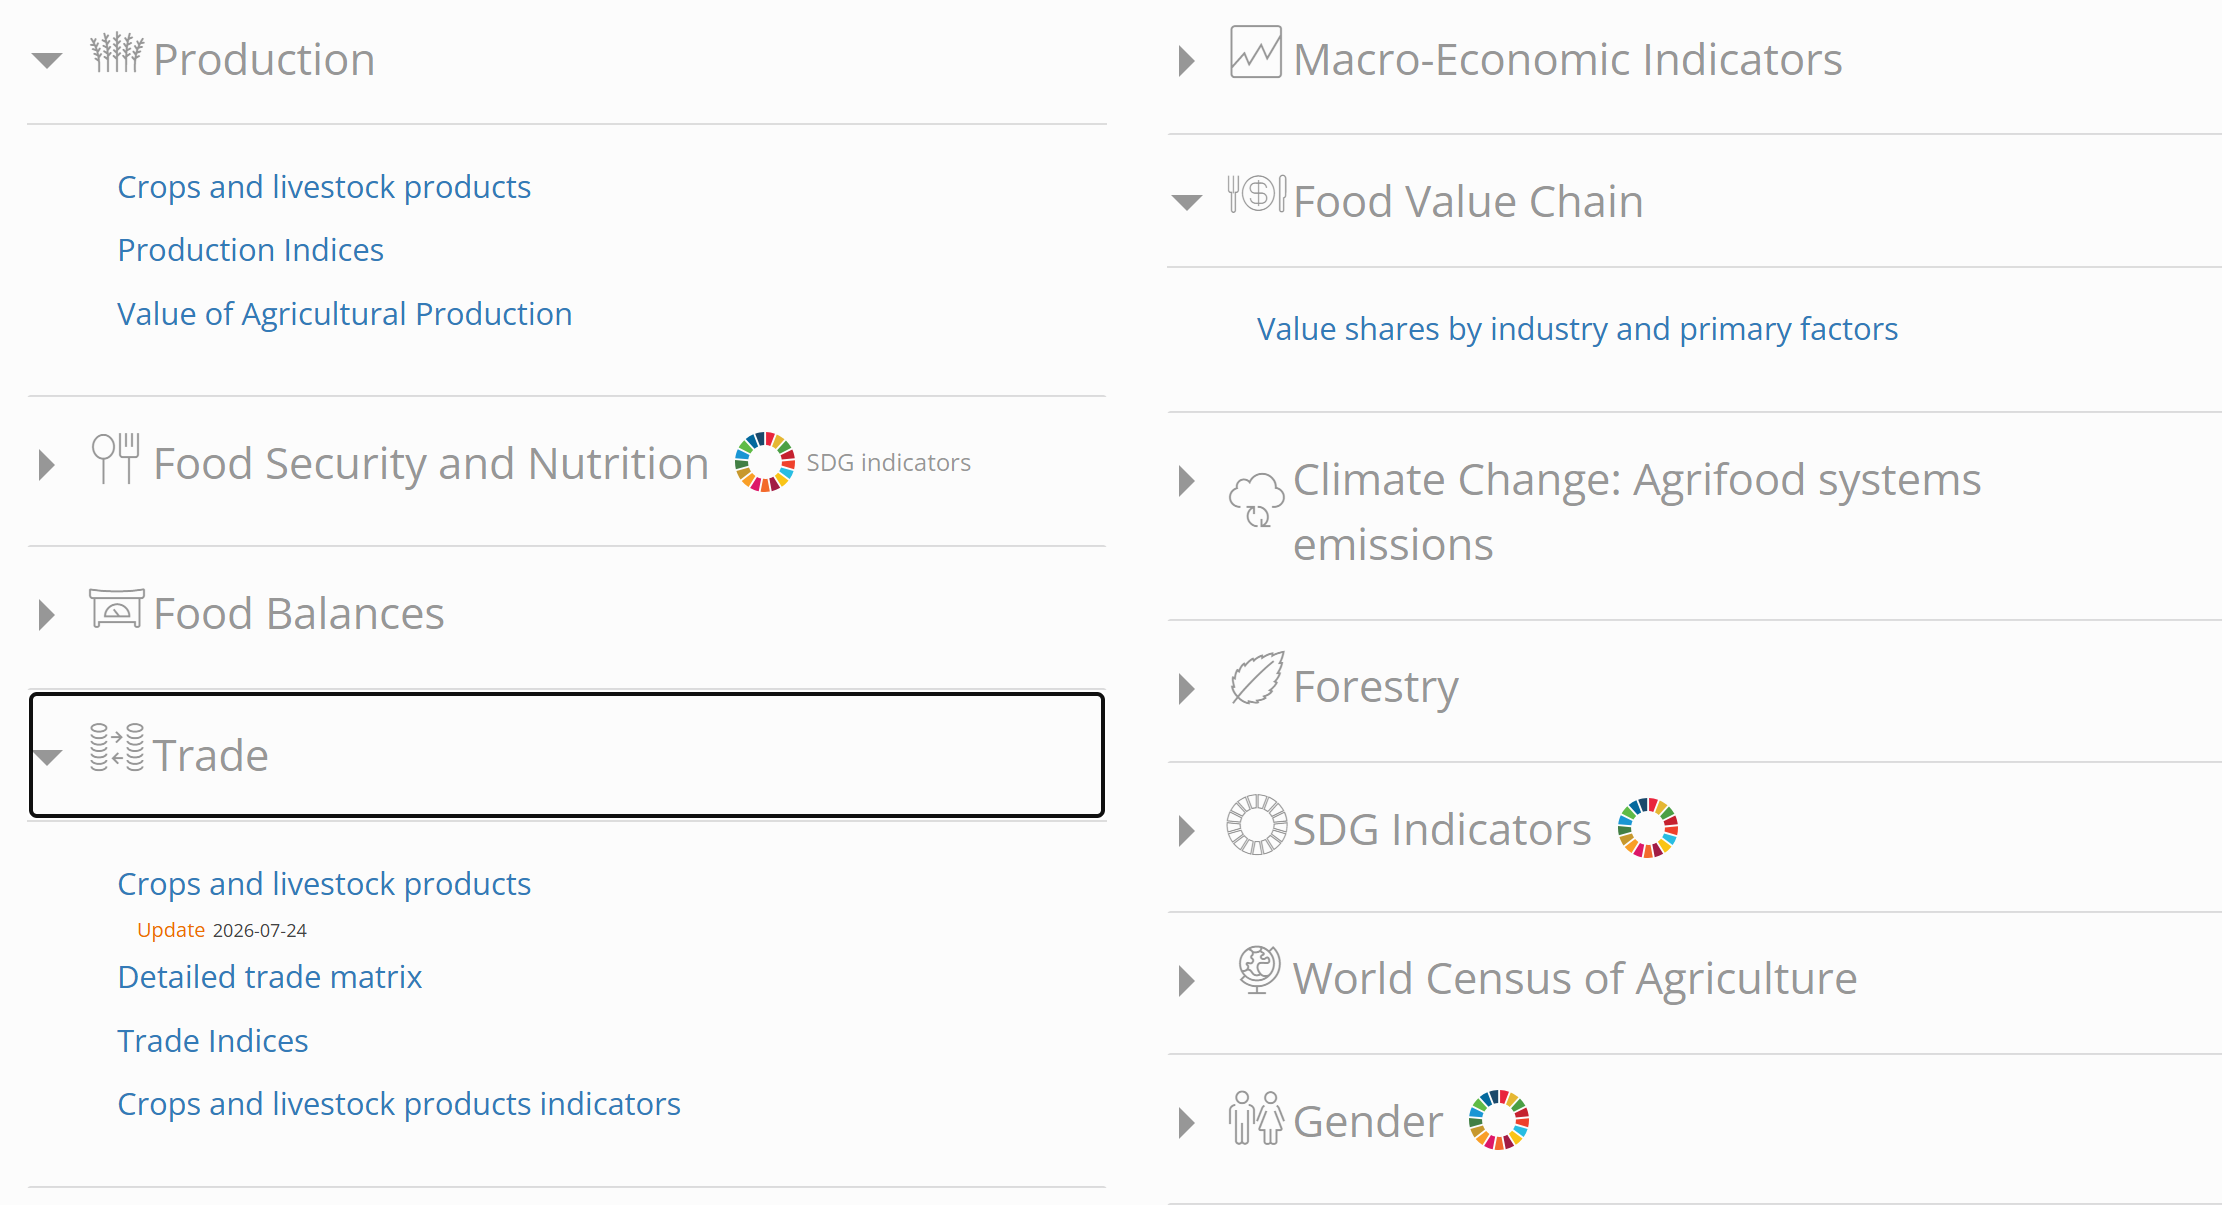
5. Cấu trúc cơ bản của dữ liệu FAOSTAT
Mặc dù mỗi dataset có đặc điểm riêng, nhiều dữ liệu FAOSTAT có thể được hiểu thông qua một số chiều cơ bản. Nắm được các chiều này giúp người học đọc dữ liệu nhanh hơn và viết lệnh Stata chính xác hơn.
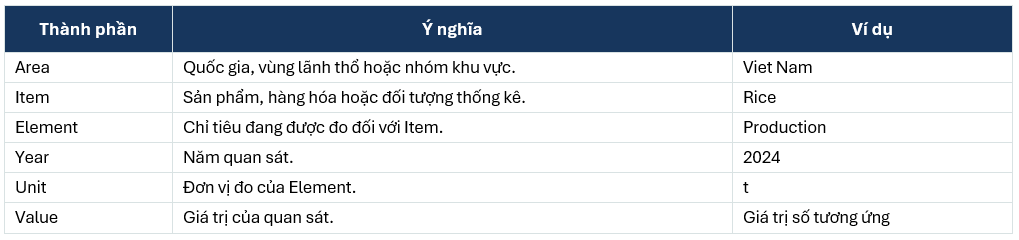
Ví dụ, một quan sát có Area là Viet Nam, Item là Rice, Element là Production, Year là 2024 và Unit là t. Ý nghĩa của quan sát là sản lượng lúa của Việt Nam trong năm 2024, được đo bằng tấn. Ví dụ:
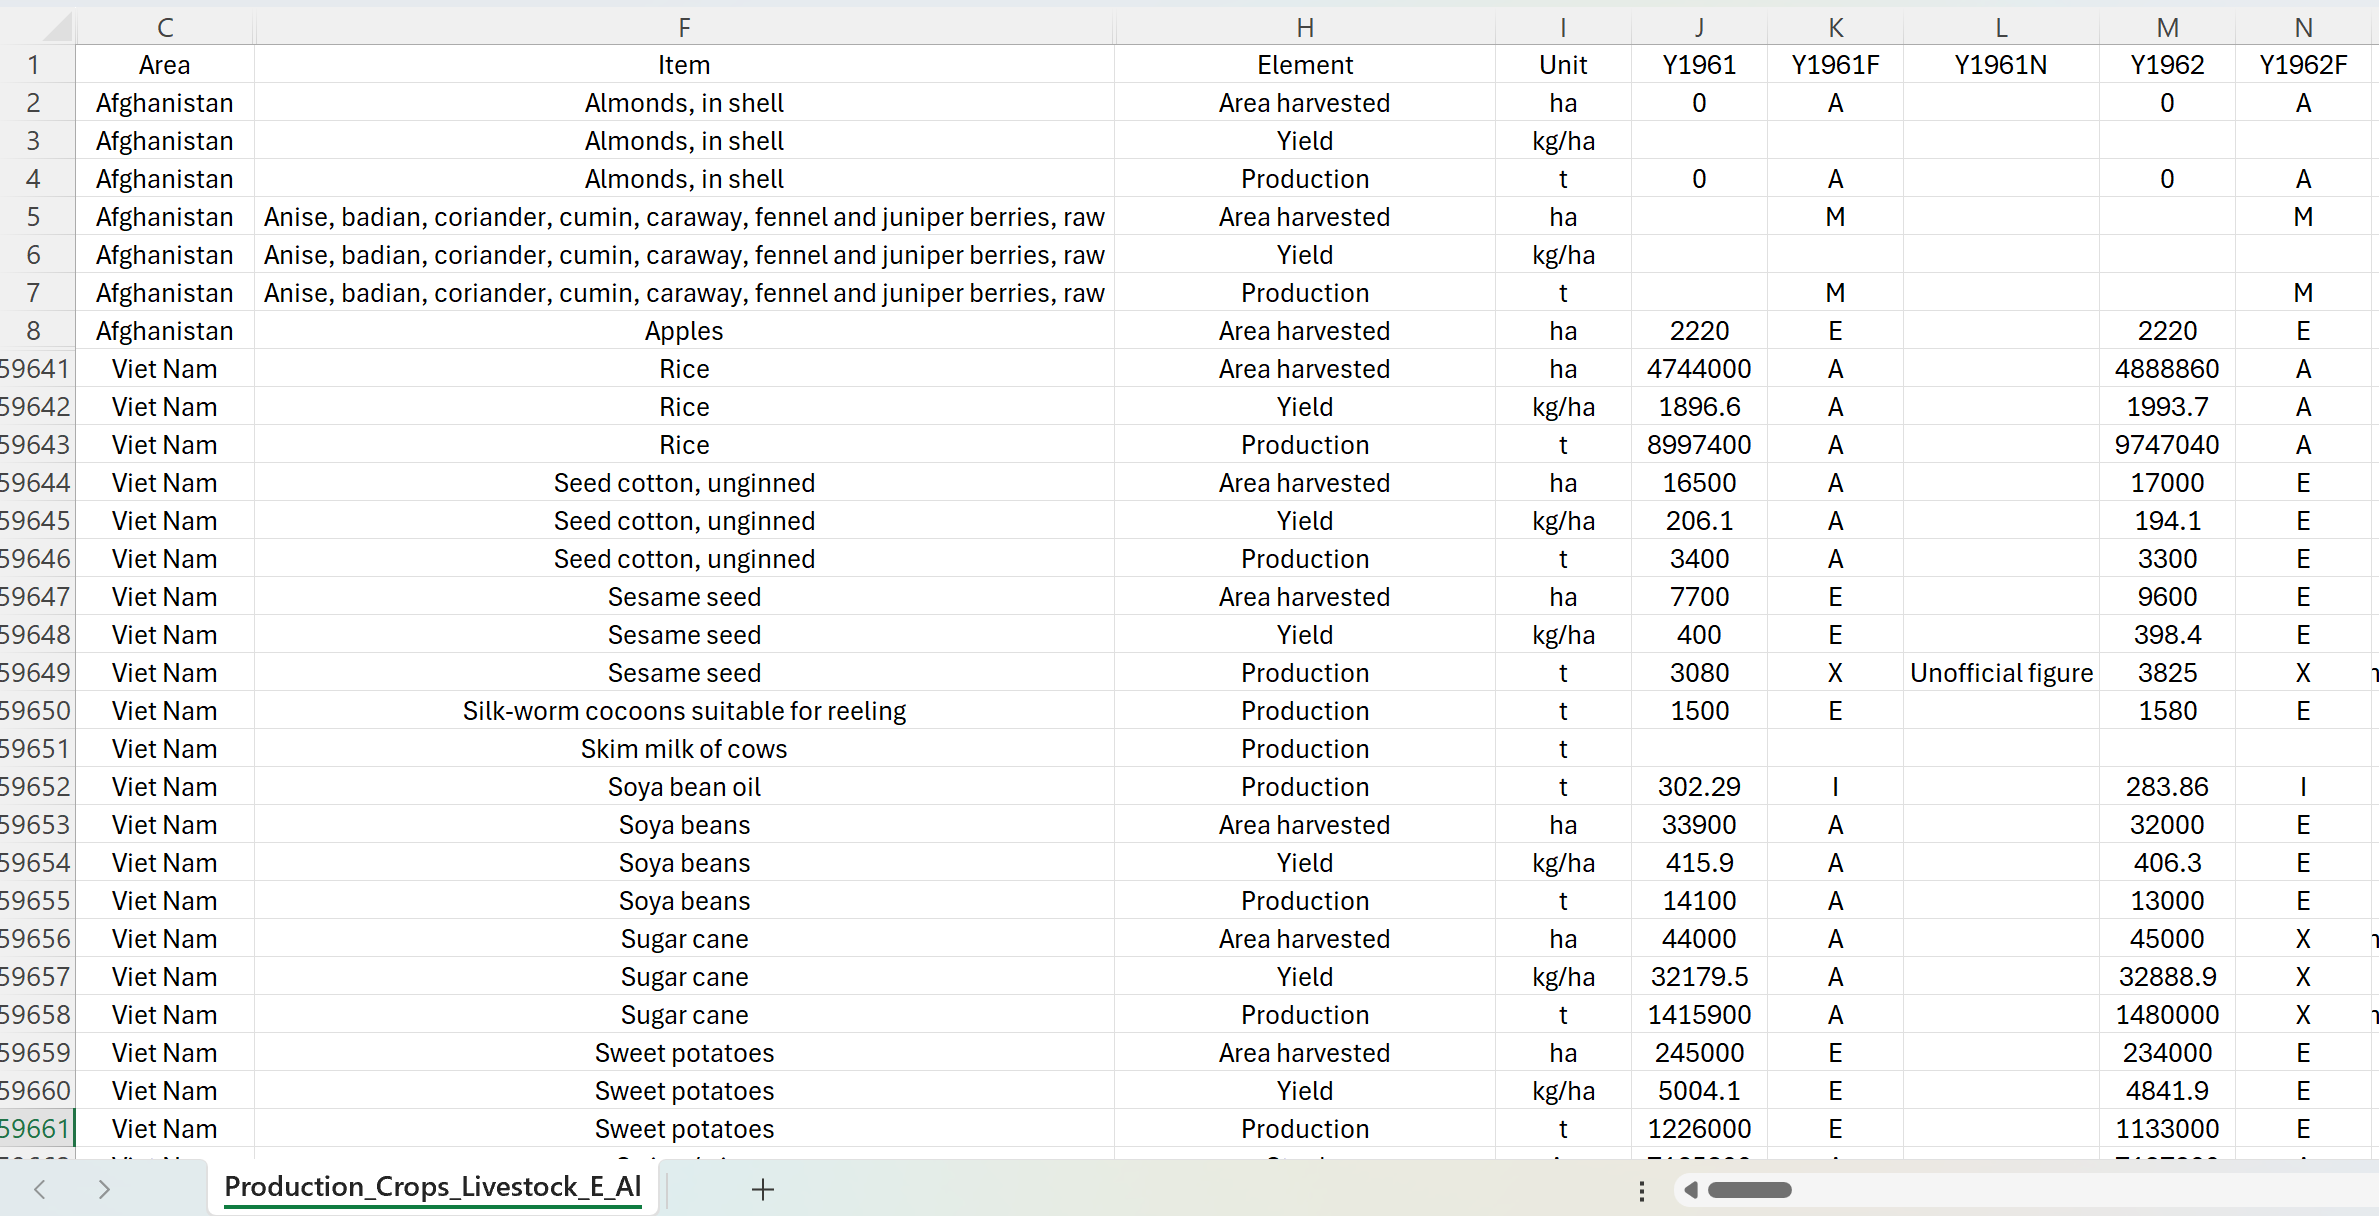
6. Hệ thống mã trong FAOSTAT
Ngoài tên hiển thị, FAOSTAT sử dụng các mã để nhận diện Area, Item và Element. Các mã này đặc biệt hữu ích khi lọc dữ liệu bằng Stata, khi làm việc với nhiều quốc gia hoặc khi ghép các dataset.

Không cần học thuộc các mã. Trong Bài 2A, chúng ta sẽ sử dụng Stata để liệt kê và kiểm tra mã quốc gia, mã sản phẩm và mã chỉ tiêu trực tiếp từ dữ liệu. Cách này thuận tiện hơn và giảm nguy cơ dùng nhầm mã.
7. Metadata: đọc dữ liệu trước khi phân tích
Metadata là phần mô tả dữ liệu. Đây là bước cần đọc trước khi bắt đầu tính toán, vì tên của một chỉ tiêu không phải lúc nào cũng đủ để hiểu chính xác cách FAO định nghĩa và xây dựng chỉ tiêu đó.

Ví dụ, khi click vào ‘Crops and livestock products’ trong Domain ‘Production’, ta thấy:

8. Flags và Notes
Nhiều dataset FAOSTAT đi kèm Flag và Note. Các trường này cung cấp thông tin bổ sung về trạng thái, nguồn gốc hoặc cách hình thành của một giá trị. Vì vậy, khi làm sạch dữ liệu không nên xóa Flag và Note một cách máy móc trước khi kiểm tra ý nghĩa của chúng trong Metadata của dataset.
Trong thực hành, một quy trình tốt là kiểm tra Unit, Flag và Note trước, sau đó mới quyết định trường nào cần giữ trong bộ dữ liệu nghiên cứu. Điều này đặc biệt quan trọng khi so sánh giữa nhiều quốc gia, vì chất lượng và phương thức hình thành số liệu có thể không hoàn toàn giống nhau.
9. Ba cách phổ biến để lấy dữ liệu FAOSTAT

Trong các bài thực hành đầu tiên, chúng ta ưu tiên Bulk Downloads (xem mục 7) nhưng để Stata tự tải file từ URL. Cách này vừa dễ kiểm soát, vừa giúp toàn bộ quy trình được lưu trong do-file. API sẽ phù hợp hơn với các workflow nâng cao khi cần truy vấn có chọn lọc hoặc tự động hóa ở mức sâu hơn.
10. Định hướng cho các bài tiếp theo
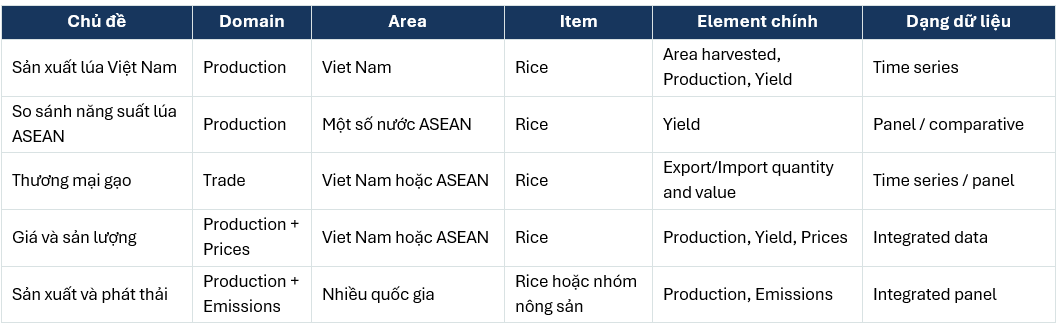
Cụ thể như sau:
Bài 1 chỉ tập trung vào việc hiểu FAOSTAT và cách tổ chức dữ liệu. Từ Bài 2, người học bắt đầu làm việc trực tiếp với Stata. Cấu trúc dự kiến của các bài tiếp theo như sau:
- Bài 2A. Khai thác và chuẩn bị dữ liệu Production cho một quốc gia: Việt Nam.
- Bài 2B. Khai thác và chuẩn bị dữ liệu Production cho nhiều quốc gia.
- Bài 3A. Phân tích dữ liệu Production của Việt Nam.
- Bài 3B. Phân tích và so sánh dữ liệu Production giữa nhiều quốc gia.
- …
- Bài ?A. Ghép dữ liệu theo thời gian cho nghiên cứu trường hợp Việt Nam.
- Bài ?B. Ghép dữ liệu đa quốc gia để xây dựng bộ dữ liệu bảng cho nghiên cứu thực nghiệm.
Lời kết
FAOSTAT là một nền tảng dữ liệu rộng và có cấu trúc, không chỉ là nơi tải các bảng số liệu. Để sử dụng FAOSTAT hiệu quả, người học cần biết lựa chọn domain, đọc Metadata, phân biệt Area, Item và Element, kiểm tra Unit, Flags và Notes, đồng thời hiểu các phương thức truy cập dữ liệu. Những kiến thức này là nền tảng để từ Bài 2 có thể xây dựng một quy trình Stata có khả năng tái sử dụng cho Production, Trade, Prices và nhiều domain khác.