

Tiếp nối Bài 3, bài này tập trung vào một kỹ năng rất quan trọng khi khai thác VHLSS: tạo các biến mới từ những biến gốc. Trong nghiên cứu thực tế, dữ liệu điều tra hiếm khi có sẵn tất cả các biến đúng theo câu hỏi nghiên cứu. Nhà nghiên cứu thường phải lựa chọn, đổi cách đặt tên, phân nhóm, tính toán hoặc tổng hợp các biến gốc để tạo ra những biến có ý nghĩa phân tích. Mục tiêu của bài không chỉ là học thêm các command của Stata, mà còn giúp bạn hình thành quy trình: biến gốc → biến mới → kiểm tra biến → tạo biến cấp hộ → thống kê và trực quan hóa. Chúng ta vẫn sử dụng tệp muc1a.dta của Mục 1a – Thông tin thành viên hộ và giữ các biến gốc để có thể đối chiếu khi cần.
1. Mở dữ liệu và nhắc lại Bài 3
cd “D:\vhlss\vhlss20\”
use muc1a.dta, clear
describe
Trước khi tạo biến mới, hãy kiểm tra lại cấu trúc dữ liệu và đối chiếu các biến cần sử dụng với bảng câu hỏi gốc trong thư mục ‘Document’.
2. Tạo biến mới với tên dễ hiểu
gen gender = m1ac2
gen relation = m1ac3
gen age = m1ac5
gen marital = m1ac8
gen memberid = m1ama
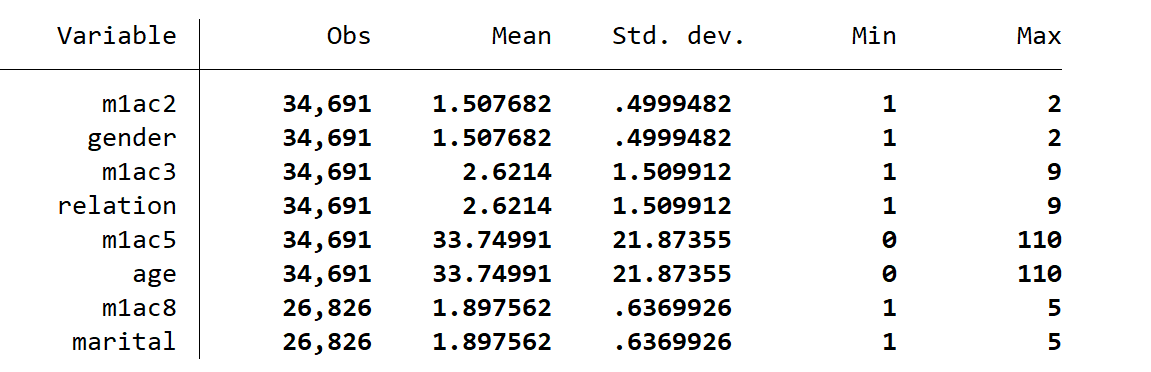
Ở đây chúng ta dùng generate (viết tắt gen) thay vì rename. Cách này tạo một biến mới nhưng vẫn giữ nguyên biến gốc, thuận tiện cho việc kiểm tra và đối chiếu dữ liệu.
label variable gender “Gender”
label variable relation “Relationship to household head”
label variable age “Age”
label variable marital “Marital status”
label variable memberid “Household member ID”
des m1ac2 gender m1ac3 relation m1ac5 age m1ac8 marital

sum m1ac2 gender m1ac3 relation m1ac5 age m1ac8 marital, sep(0)
3. Giữ lại các biến cần thiết
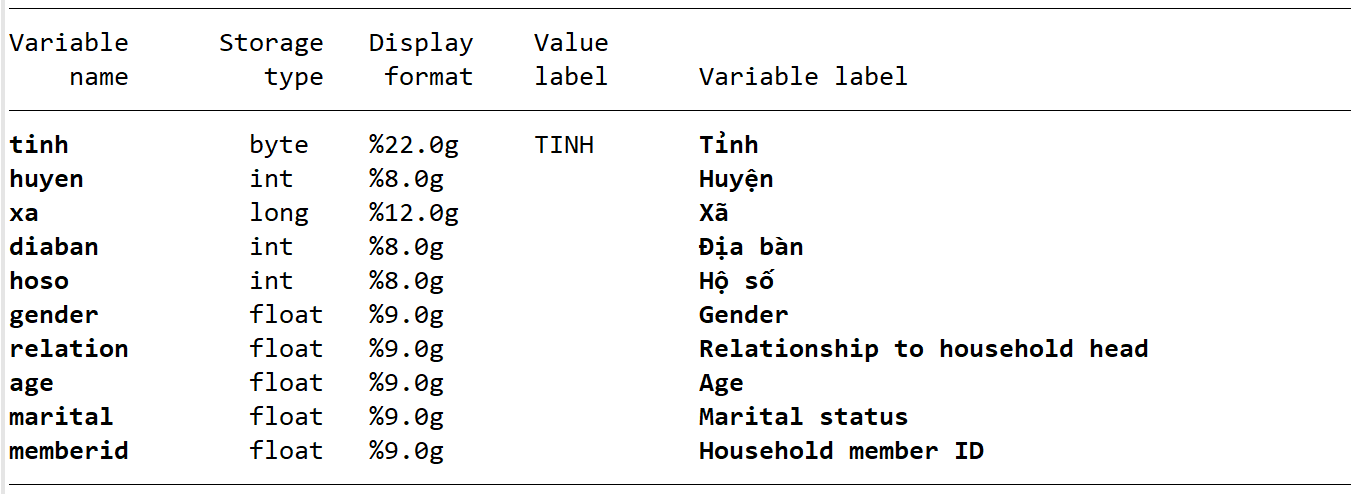
keep tinh huyen xa diaban hoso memberid gender relation age marital
des
4. Tạo biến giả (dummy variable)
Biến giả thường chỉ nhận hai giá trị 0 và 1. Đây là dạng biến được sử dụng rất phổ biến trong phân tích dữ liệu và hồi quy.
gen hhhead = (relation == 1)
gen female = (gender == 2)
gen married = (marital == 2)
label variable hhhead “Household head”
label variable female “Female”
label variable married “Currently married”
tab hhhead
tab female
tab married

5. Tạo biến nhóm tuổi
Biến age là biến định lượng. Trong một số nghiên cứu, chúng ta cần chuyển tuổi thành các nhóm để thuận tiện cho việc mô tả hoặc so sánh.
gen agegroup = .
replace agegroup = 1 if age < 15
replace agegroup = 2 if age >= 15 & age < 25
replace agegroup = 3 if age >= 25 & age < 60
replace agegroup = 4 if age >= 60
label define agegr 1 “Under 15” 2 “15-24” 3 “25-59” 4 “60+”, replace
label values agegroup agegr
label variable agegroup “Age group”
tab agegroup
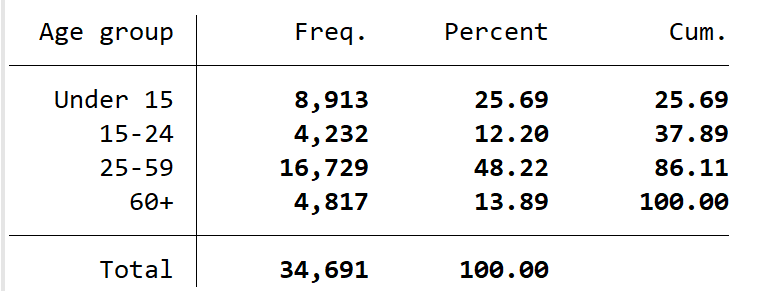
Qua ví dụ này, chúng ta sử dụng gen để tạo biến và replace để thay thế giá trị của biến theo từng điều kiện.
6. Một cách khác để tạo nhóm: recode
recode age (0/14=1) (15/24=2) (25/59=3) (60/max=4), gen(agegroup2)
label values agegroup2 agegr
tab agegroup agegroup2
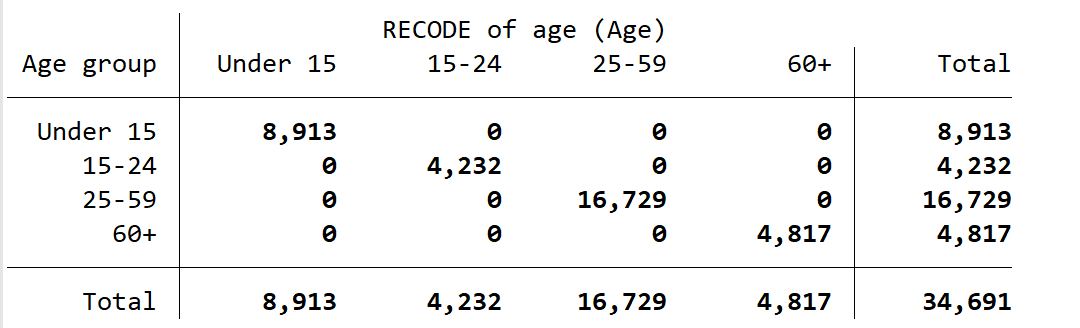
Lệnh recode cho phép phân nhóm một biến theo các khoảng giá trị. Đây là ví dụ cho thấy cùng một mục tiêu trong Stata có thể được thực hiện bằng nhiều cách khác nhau.
7. Tạo biến bằng hàm toán học
Stata có nhiều hàm toán học có thể dùng khi tạo biến. Ví dụ, để minh họa hàm logarithm:
gen lnage = log(age) if age > 0
sum age lnage
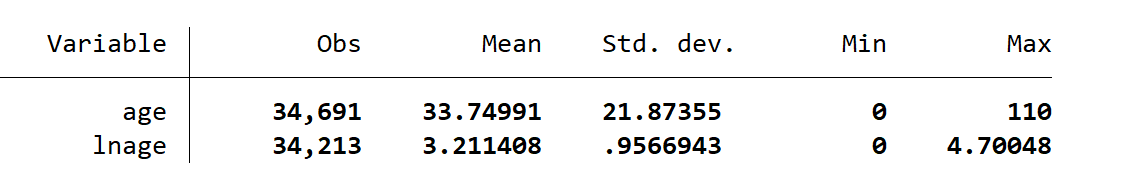
hist lnage if hhhead == 1, title(“Distribution of Log Age of Household Heads”)
hist lnage if hhhead == 1, title(“Phân phối logarithm tuổi của chủ hộ”, size(small))
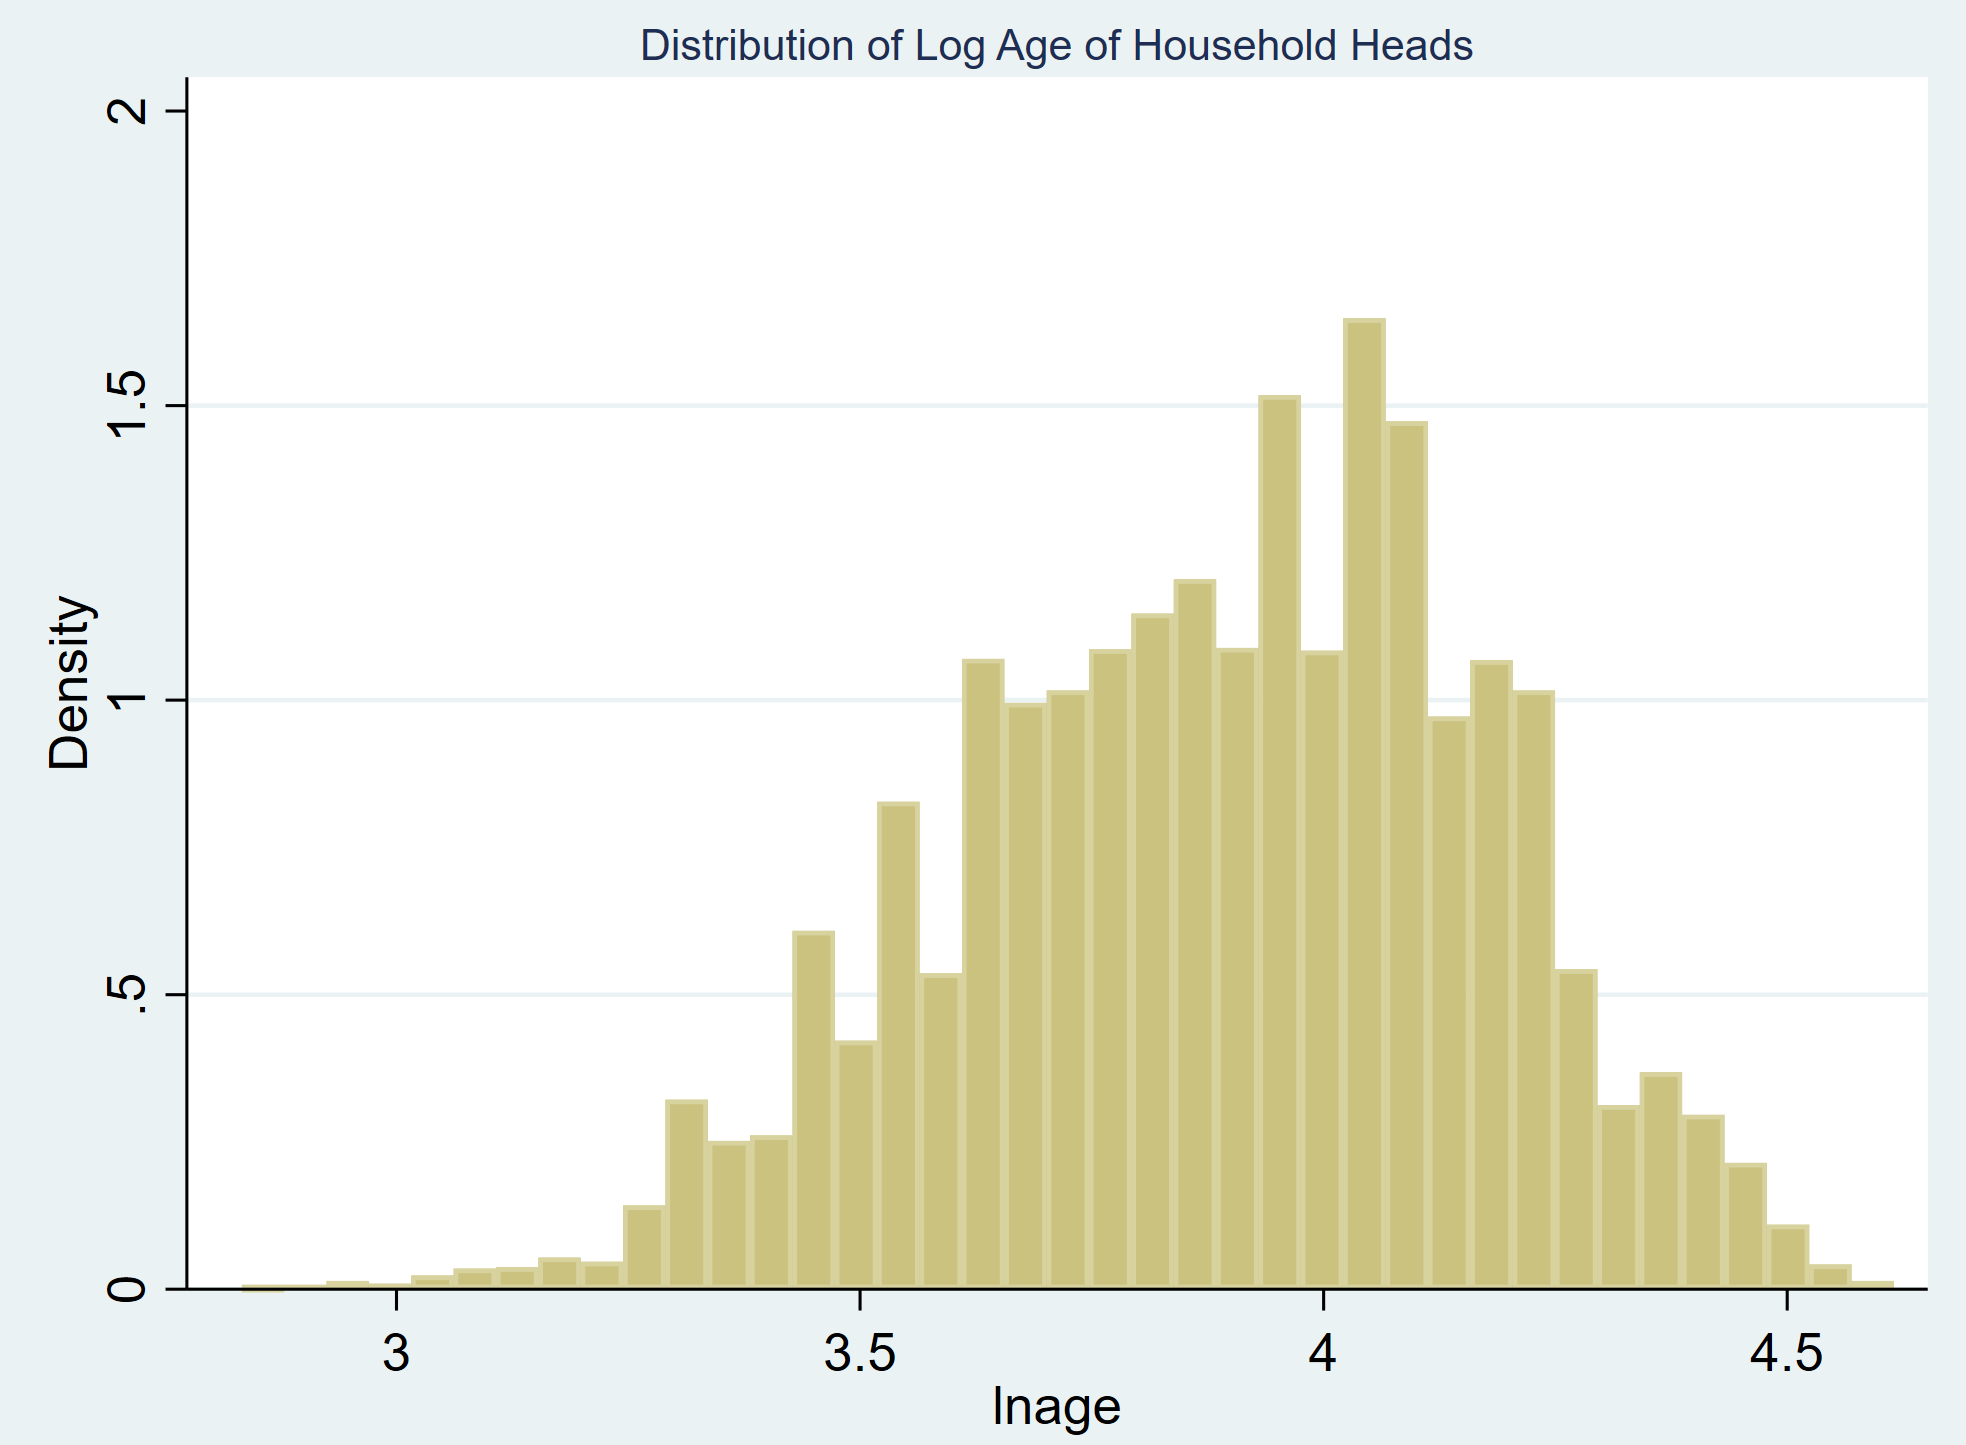
Lưu ý: Logarithm của tuổi chủ yếu được dùng ở đây để minh họa cách sử dụng log(). Trong nghiên cứu sử dụng dữ liệu VHLSS, phép biến đổi logarithm thường có ý nghĩa thực tế hơn đối với các biến như thu nhập, chi tiêu hoặc tài sản. Điều kiện age > 0 tránh trường hợp log(0), vốn không xác định.
8. Tạo biến quy mô hộ (household size)
Mỗi dòng trong muc1a.dta tương ứng với một thành viên hộ. Vì vậy, số quan sát thuộc cùng một hộ chính là số thành viên của hộ đó.
bysort tinh huyen xa diaban hoso: gen hhsize = _N
label variable hhsize “Household size”
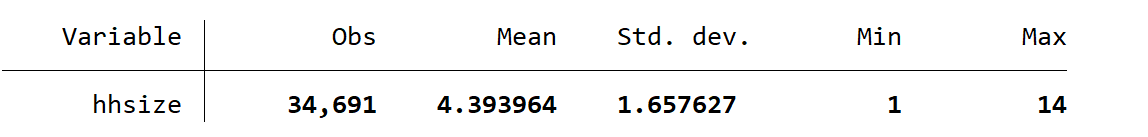
Trong lệnh trên, bysort nhóm các thành viên thuộc cùng một hộ; _N cho biết tổng số quan sát trong từng nhóm. Do đó, mỗi thành viên của cùng một hộ sẽ nhận cùng một giá trị hhsize.
9. Tạo quy mô hộ bằng egen
egen hhsize1 = count(memberid), by(tinh huyen xa diaban hoso)
label variable hhsize1 “Household size (egen)”
format hhsize1 %10.0f
So sánh:
sum hhsize hhsize1
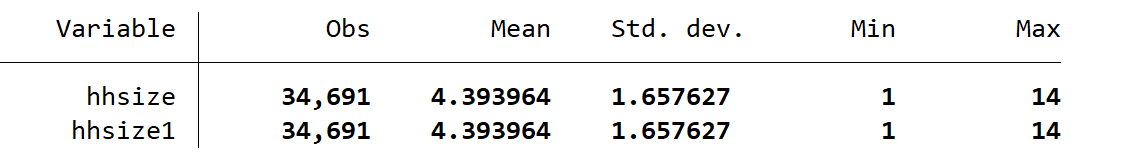
Lệnh egen cung cấp nhiều hàm mở rộng để tạo biến. Ở đây count() đếm số memberid trong từng hộ.
10. Kiểm tra hai cách tạo quy mô hộ
assert hhsize == hhsize2
Lệnh assert kiểm tra xem một điều kiện có đúng với tất cả các quan sát hay không. Nếu Stata không báo lỗi, hhsize và hhsize2 giống nhau ở tất cả các quan sát. Đây là một cách rất hữu ích để kiểm tra code và tính nhất quán của biến mới.
11. Hiểu _n và _N
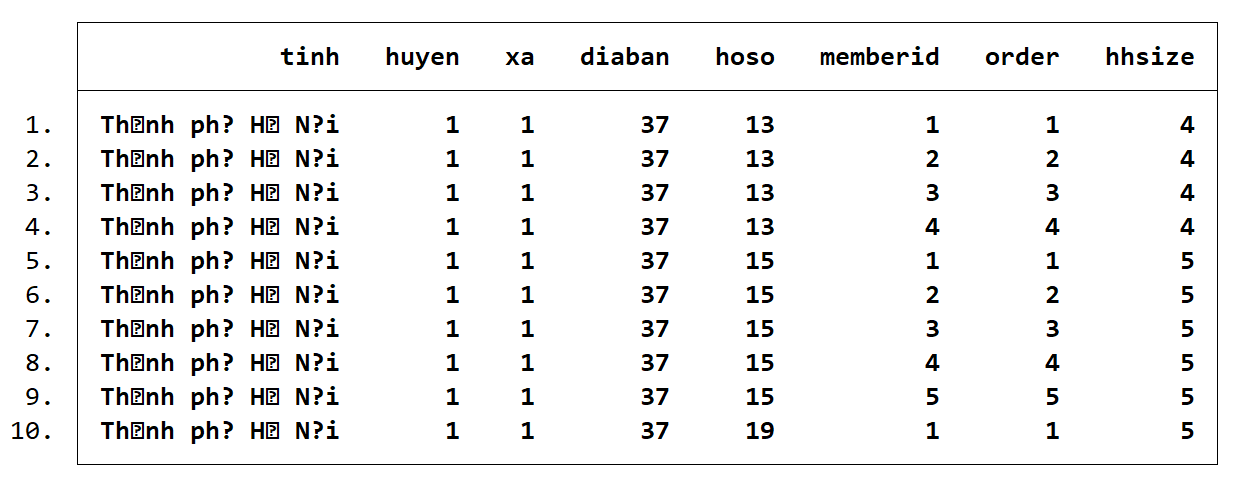
bysort tinh huyen xa diaban hoso (memberid): gen order = _n
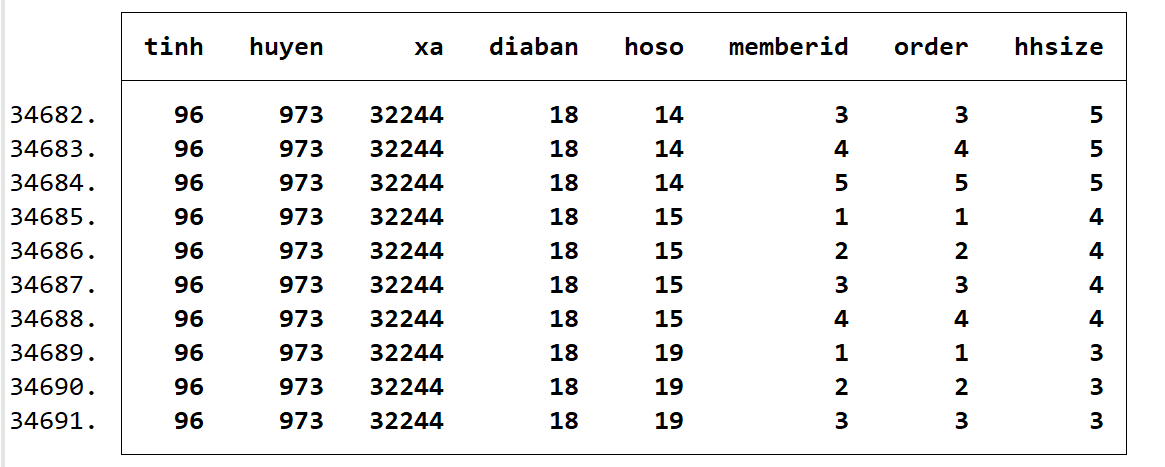
_n cho biết số thứ tự của quan sát trong từng nhóm, trong khi _N cho biết tổng số quan sát của nhóm. Ví dụ, trong một hộ có bốn thành viên, order lần lượt bằng 1, 2, 3, 4 và hhsize bằng 4 cho cả bốn thành viên.
list tinh huyen xa diaban hoso memberid order hhsize in 1/10
list tinh huyen xa diaban hoso memberid order hhsize in -10/l, sep(0) nolabel
12. Tạo biến trẻ em và người cao tuổi
gen child = (age < 15)
gen elderly = (age >= 60)
label variable child “Child under 15”
label variable elderly “Person aged 60 or over”
tab child
tab elderly
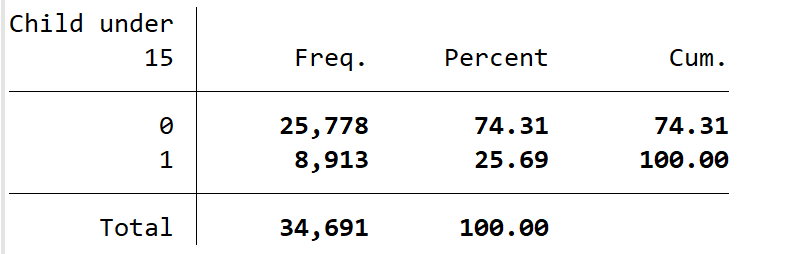
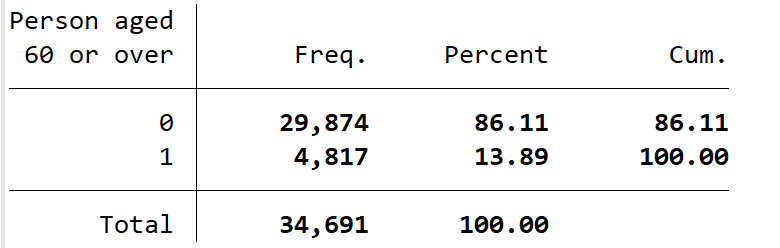
Các biến này minh họa cách chuyển một điều kiện về tuổi thành biến giả có thể sử dụng trong các phân tích tiếp theo.
13. Tạo số trẻ em và người cao tuổi trong hộ
bysort tinh huyen xa diaban hoso: egen nchild = total(child)
bysort tinh huyen xa diaban hoso: egen nelderly = total(elderly)
label variable nchild “Number of children under 15”
label variable nelderly “Number of persons aged 60 or over”
sum hhsize nchild nelderly

Khác với child và elderly ở cấp cá nhân, nchild và nelderly là đặc điểm của cả hộ và có cùng giá trị đối với tất cả thành viên thuộc cùng một hộ.
14. Thực hành nâng cao: tạo tỷ lệ phụ thuộc
gen dependent = (age < 15 | age >= 65)
gen workingage = (age >= 15 & age < 65)
bysort tinh huyen xa diaban hoso: egen ndep = total(dependent)
bysort tinh huyen xa diaban hoso: egen nwork = total(workingage)
gen depratio = ndep / nwork if nwork > 0
label variable depratio “Dependency ratio”
sum depratio

Ví dụ này cho thấy một chỉ tiêu nghiên cứu có thể được xây dựng qua nhiều bước từ dữ liệu thành viên. Điều kiện nwork > 0 giúp tránh phép chia cho 0.
15. Thống kê mô tả theo chủ hộ
tabstat age, by(hhhead) stats(mean sd min max n)
tab marital hhhead
tab marital hhhead, row col
tab gender hhhead
tab gender agegroup, col

16. Phân biệt dữ liệu cấp cá nhân và cấp hộ
Đây là một điểm rất quan trọng. Vì muc1a.dta là dữ liệu cấp thành viên, biến hhsize được lặp lại cho tất cả thành viên trong cùng một hộ. Một hộ có 5 thành viên sẽ có 5 dòng cùng mang hhsize = 5. Vì vậy, nếu muốn thống kê quy mô hộ theo đúng cấp hộ, chúng ta cần bảo đảm mỗi hộ chỉ được tính một lần.
bysort tinh huyen xa diaban hoso: gen first = (_n == 1)
label variable first “First observation in household”
tab first
sum hhsize if first == 1

Biến first bằng 1 ở quan sát đầu tiên của mỗi hộ. Điều kiện first == 1 vì vậy giúp mỗi hộ chỉ xuất hiện một lần trong thống kê.
17. Kiểm tra số hộ
count if first == 1
Kết quả cho biết số hộ có trong dữ liệu sau khi xác định quan sát đầu tiên của từng hộ. Đây cũng là một cách đơn giản để phân biệt số thành viên với số hộ.
18. Thống kê quy mô hộ và các đặc điểm hộ
sum hhsize nchild nelderly if first == 1
tabstat hhsize nchild nelderly if first == 1, stats(mean sd min max n)

Khi phân tích các biến cấp hộ, điều kiện first == 1 giúp tránh việc các hộ lớn được tính lặp lại nhiều lần chỉ vì có nhiều thành viên hơn.
19. Vẽ phân phối quy mô hộ
hist hhsize if first == 1, discrete percent

Tùy chọn discrete phù hợp vì quy mô hộ nhận các giá trị rời rạc như 1, 2, 3,…; percent hiển thị tỷ lệ phần trăm thay vì tần số.
20. So sánh quy mô hộ giữa một số tỉnh/thành phố
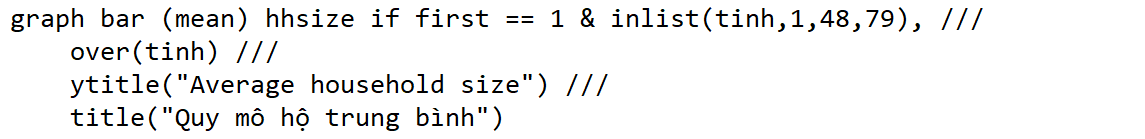

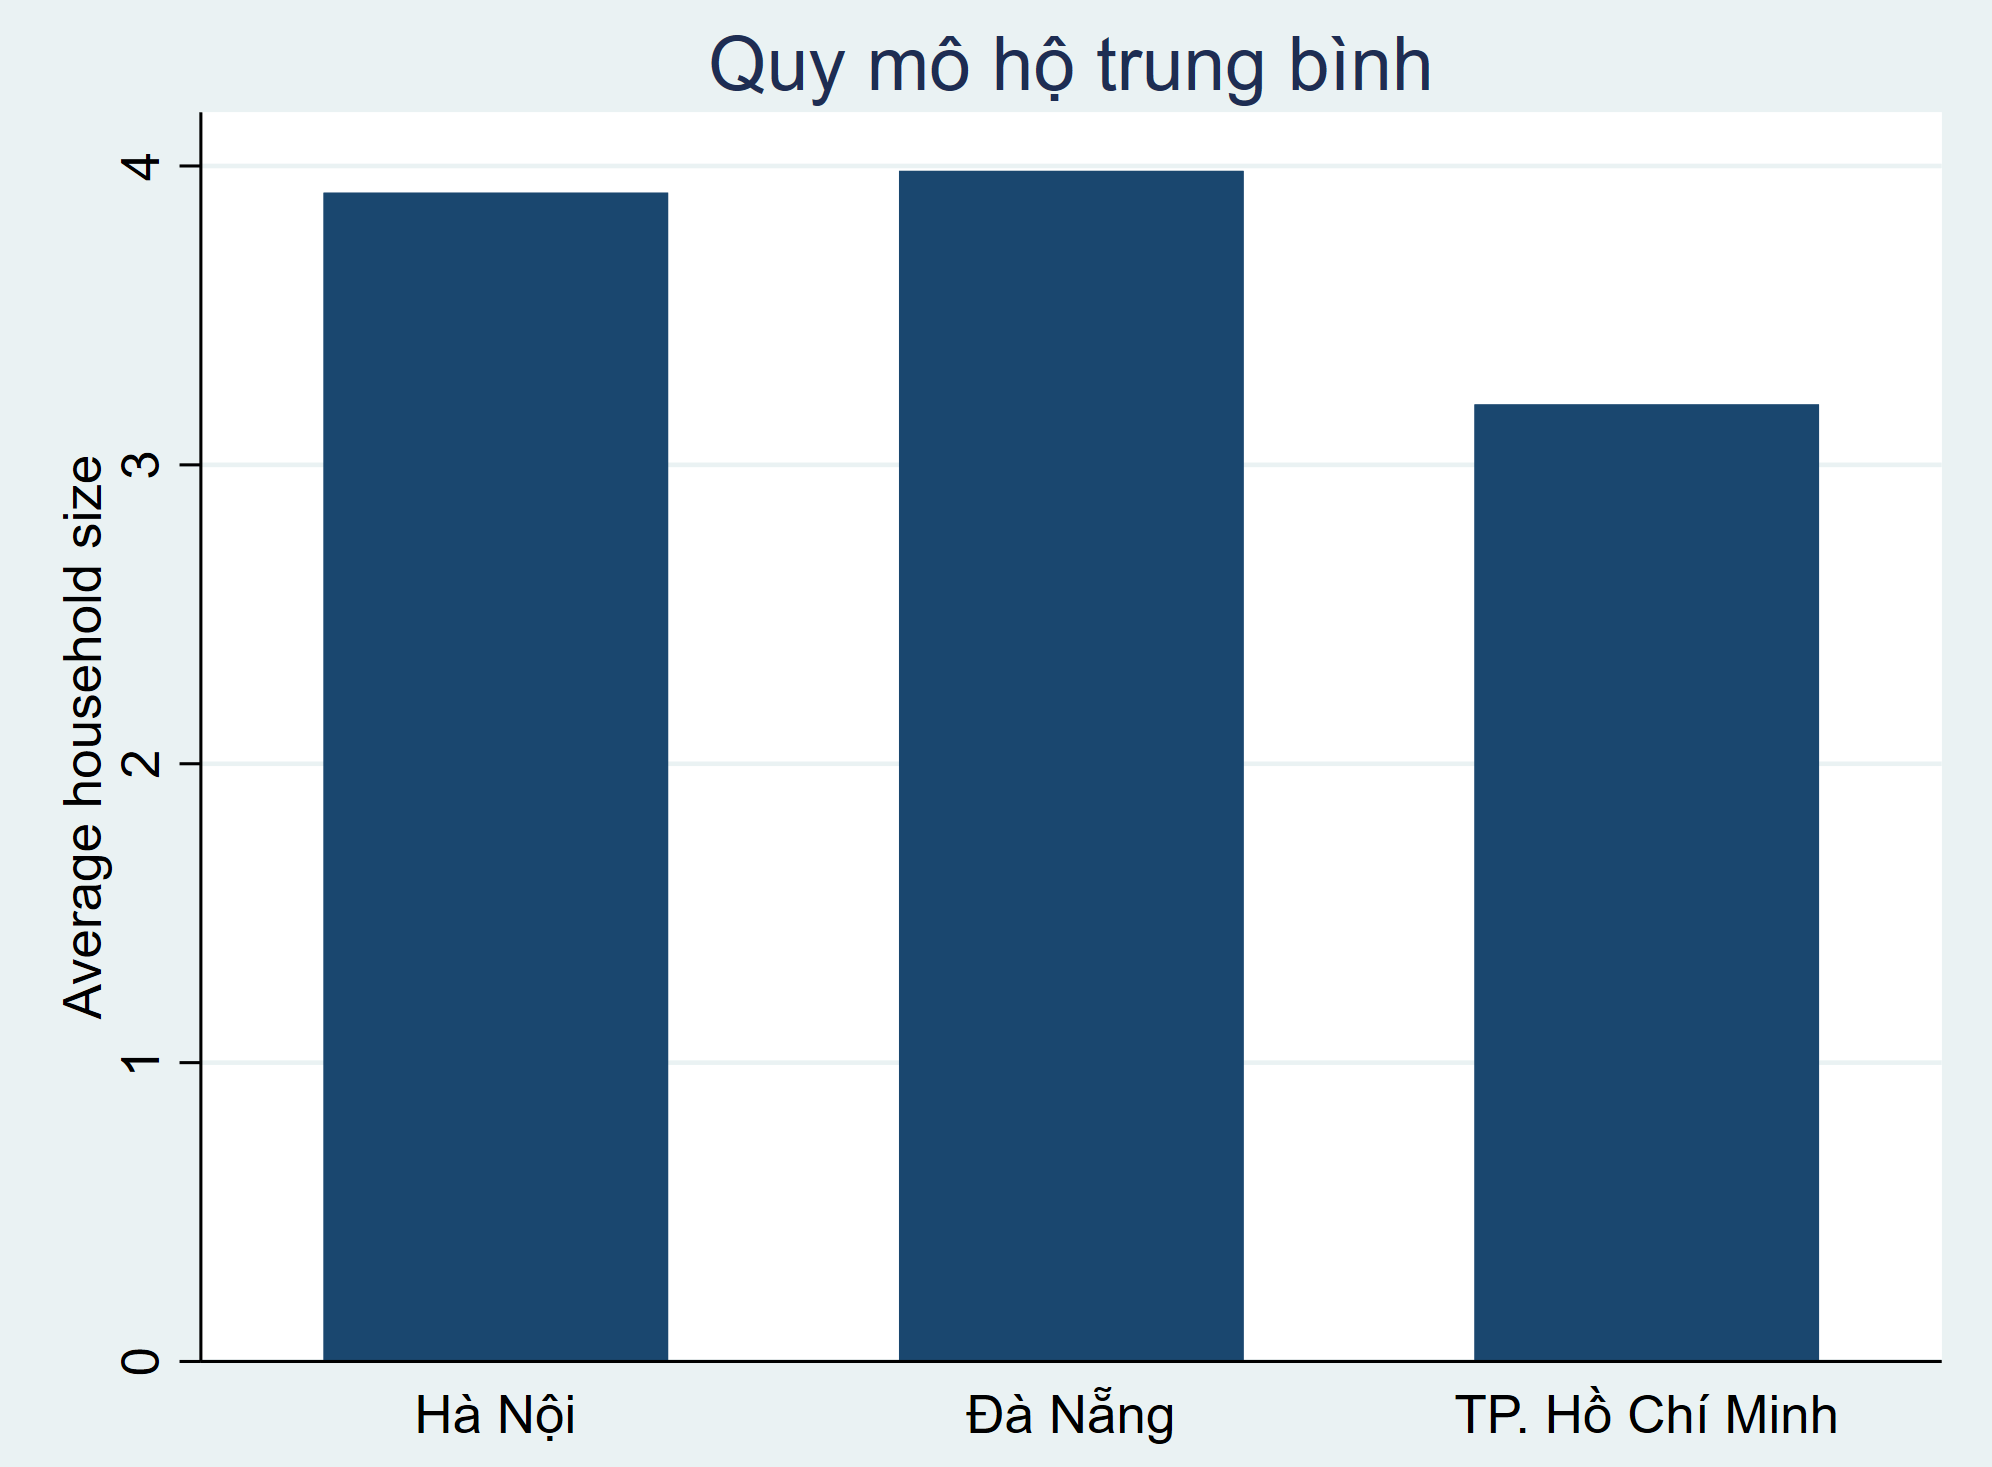
21. Tạo mã định danh cho hộ và thành viên hộ
Trong các phần trên, để xác định một hộ gia đình, chúng ta thường phải sử dụng đồng thời nhiều biến: tinh huyen xa diaban hoso.
Cách này chính xác nhưng khá dài và bất tiện khi phải lặp lại trong nhiều command, đặc biệt khi sử dụng bysort, egen, merge hoặc kiểm tra dữ liệu. Vì vậy, chúng ta có thể tạo một mã định danh duy nhất cho mỗi hộ (Household ID) và sử dụng một biến duy nhất thay cho toàn bộ nhóm biến trên.
Có thể thực hiện bằng:
egen hhid = group(tinh huyen xa diaban hoso)
Trong đó:
egenlà phiên bản mở rộng củagenerate;group()tạo một mã số duy nhất cho mỗi tổ hợp khác nhau củatinh,huyen,xa,diabanvàhoso;hhidlà viết tắt của Household ID.
Sau đó, đặt nhãn cho biến:
label variable hhid “Household ID”
Tất cả các thành viên thuộc cùng một hộ sẽ có cùng một hhid.
Ví dụ:
list tinh huyen xa diaban hoso hhid memberid hhsize in -15/l, sep(0)

Sau khi có hhid, những command trước đây phải sử dụng nhiều biến có thể được viết ngắn hơn. Chẳng hạn, ở phần trước chúng ta tạo quy mô hộ bằng:
bysort tinh huyen xa diaban hoso: gen hhsize = _N
Bây giờ có thể viết:
bysort hhid: gen hhsize2 = _N
So sánh:
sum hhsize hhsize2

Tạo mã định danh cho từng thành viên hộ
Trong muc1a.dta, mỗi dòng dữ liệu tương ứng với một thành viên của hộ. Mỗi thành viên đã có một mã riêng là memberid, được tạo từ biến gốc m1ama:
gen memberid = m1ama
Tuy nhiên, memberid chỉ xác định thành viên trong phạm vi một hộ. Chẳng hạn, hộ 101 có thành viên số 1 và hộ 102 cũng có thể có thành viên số 1. Vì vậy, memberid một mình không thể xác định duy nhất một cá nhân trong toàn bộ bộ dữ liệu.
Có thể kiểm tra bằng:
isid memberid
Stata sẽ báo rằng memberid không xác định duy nhất các quan sát.
Nhưng khi kết hợp:
hhid memberid
mỗi thành viên sẽ được xác định duy nhất. Kiểm tra bằng:
isid hhid memberid
Nếu Stata không báo lỗi, tổ hợp hhid và memberid xác định duy nhất từng thành viên trong dữ liệu.
egen pid = group(hhid memberid)
label variable pid “Person ID”
Kiểm tra:
list hhid memberid pid hhsize gender relation age hhhead in 98/114, sep(0)
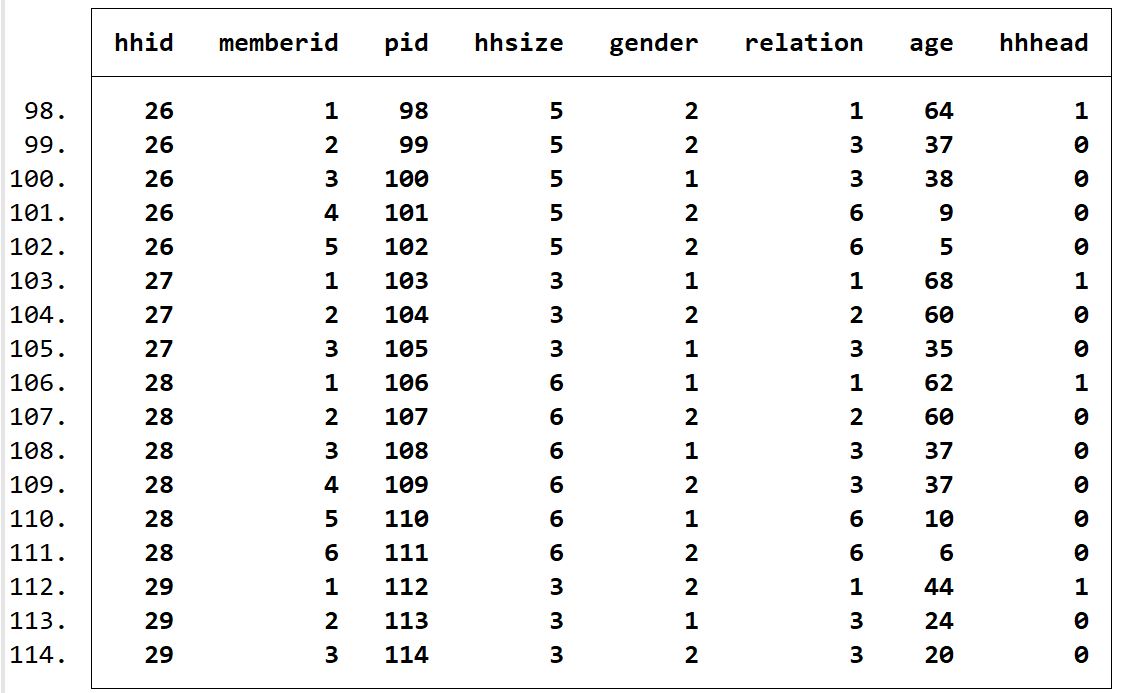
Lưu ý: hhid và pid được tạo bằng egen group() là các mã số do Stata tạo dựa trên các tổ hợp giá trị có trong bộ dữ liệu đang mở. Vì vậy, khi merge nhiều tệp dữ liệu VHLSS, không nên tạo độc lập hhid hoặc pid trong từng tệp rồi mặc nhiên cho rằng các mã này sẽ giống nhau. Khi học đến phần merge, chúng ta sẽ sử dụng các biến định danh gốc làm khóa ghép hoặc xây dựng ID theo một quy trình nhất quán giữa các tệp.
Lời kết
Trong Bài 3, chúng ta chủ yếu làm quen với việc đọc, kiểm tra và mô tả dữ liệu. Sang Bài 4, chúng ta đã tiến thêm một bước quan trọng: sử dụng các biến gốc của VHLSS 2020 để tạo và chuyển đổi các biến mới phù hợp hơn với mục đích nghiên cứu. Qua bài này, bạn đã thực hành các command và cấu trúc quan trọng như generate, replace, recode, egen, bysort, _n, _N và assert; đồng thời biết cách tạo biến giả, phân nhóm tuổi, tính quy mô hộ (hhsize), số trẻ em (nchild), số người cao tuổi (nelderly) và tỷ lệ phụ thuộc (depratio).
Một điểm đặc biệt quan trọng là phải luôn xác định đúng đơn vị quan sát (unit of observation). Trong muc1a.dta, mỗi dòng dữ liệu tương ứng với một thành viên hộ. Tuy nhiên, từ dữ liệu cấp thành viên, chúng ta có thể tổng hợp để tạo ra các đặc điểm ở cấp hộ như quy mô hộ, số trẻ em và số người cao tuổi. Vì các biến cấp hộ được lặp lại cho tất cả thành viên trong cùng một hộ, khi thực hiện thống kê ở cấp hộ chúng ta cần tránh tính một hộ nhiều lần. Biến first được tạo trong bài này giúp mỗi hộ chỉ được đưa vào phân tích một lần khi cần thiết.
Bài này cũng giới thiệu một bước quan trọng trong quản lý dữ liệu là xây dựng mã định danh (ID). Từ các biến địa lý và mã hộ tinh, huyen, xa, diaban và hoso, chúng ta tạo hhid (Household ID) để xác định từng hộ. Kết hợp hhid với memberid, chúng ta tiếp tục tạo pid (Person ID) để xác định duy nhất từng thành viên trong toàn bộ dữ liệu. Việc xây dựng các ID này không chỉ giúp do-file ngắn gọn và dễ đọc hơn mà còn giúp bạn hiểu rõ sự khác biệt giữa dữ liệu cấp hộ (household-level data) và dữ liệu cấp cá nhân (individual-level data).
Như vậy, sau Bài 4, dữ liệu không còn đơn thuần là các biến gốc được cung cấp sẵn trong VHLSS. Chúng ta đã bắt đầu biến dữ liệu điều tra gốc thành dữ liệu phục vụ nghiên cứu thông qua việc tạo biến, phân nhóm, tổng hợp, kiểm tra và xây dựng mã định danh. Trong các bài tiếp theo, chúng ta sẽ tiếp tục khai thác Mục 1A để lấy các đặc điểm của chủ hộ, xây dựng và chuẩn hóa các biến địa lý như tỉnh/thành phố và vùng (region), đồng thời từng bước chuẩn bị dữ liệu để ghép (merge) với các mục khác của VHLSS 2020, hướng tới xây dựng một bộ dữ liệu hoàn chỉnh phù hợp với từng câu hỏi và mục tiêu nghiên cứu.