

Trong Bài 4, chúng ta đã sử dụng các biến gốc của VHLSS 2020 để tạo ra nhiều biến mới ở cấp cá nhân và cấp hộ, chẳng hạn gender, relation, age, marital, hhsize, nchild, nelderly, hhid và pid. Sang Bài 5, chúng ta tiếp tục làm việc với Mục 1a nhưng tập trung vào một kỹ thuật rất quan trọng trong xử lý dữ liệu: xoay dữ liệu (reshape).
Mục tiêu của bài là giúp bạn hiểu sự khác nhau giữa dữ liệu dạng long và wide, biết cách sử dụng reshape long và reshape wide, hiểu vai trò của i(), j() và stub, nhận biết một số lỗi thường gặp khi xoay dữ liệu, sau đó áp dụng vào VHLSS 2020 để chuyển dữ liệu từ cấp thành viên sang cấp hộ và tạo các đặc điểm của chủ hộ như giới tính, tuổi và tình trạng hôn nhân.
Trong phần đầu, chúng ta chưa sử dụng ngay VHLSS mà sẽ bắt đầu bằng một số bộ dữ liệu mẫu có sẵn trong Stata. Cách này giúp bạn hiểu logic của reshape trên những ví dụ nhỏ trước khi áp dụng vào một bộ dữ liệu phức tạp hơn.
1. Hiểu dữ liệu dạng long và wide
Trước khi sử dụng reshape, cần phân biệt hai cách tổ chức dữ liệu phổ biến.
Trong dữ liệu dạng long, một đơn vị có thể xuất hiện trên nhiều dòng.
Ví dụ:
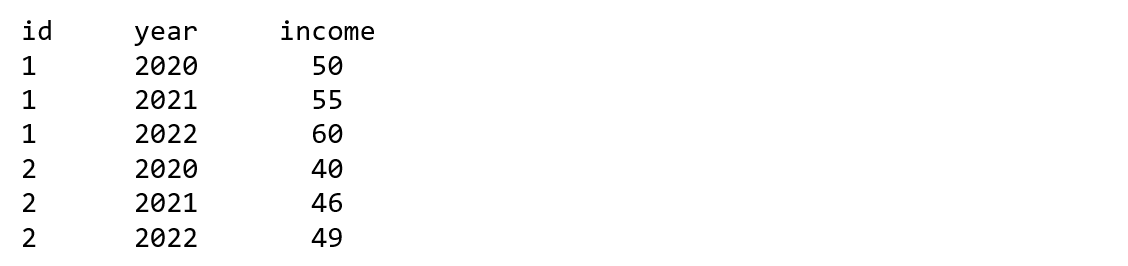
Ở đây, mỗi id xuất hiện nhiều lần vì mỗi dòng tương ứng với một năm khác nhau.
Dữ liệu dạng wide
Cùng dữ liệu trên có thể được trình bày như sau:
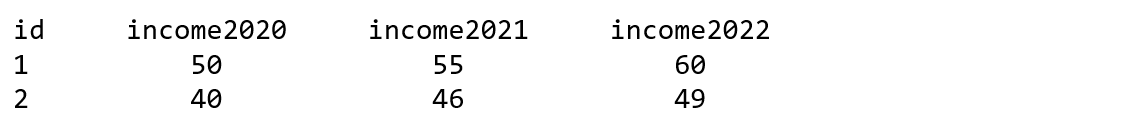
Mỗi id chỉ xuất hiện một lần, nhưng thông tin theo năm được trải thành nhiều cột.
Có thể nhớ đơn giản:
long = nhiều dòng hơn, ít cột hơn; wide = ít dòng hơn, nhiều cột hơn.
Lệnh reshape cho phép chúng ta chuyển đổi qua lại giữa hai cấu trúc này.
2. Ví dụ 1 – xoay từ wide sang long và ngược lại
Mở bộ dữ liệu mẫu của Stata (sử dụng help reshape):
webuse reshape1, clear
Xem dữ liệu:
list
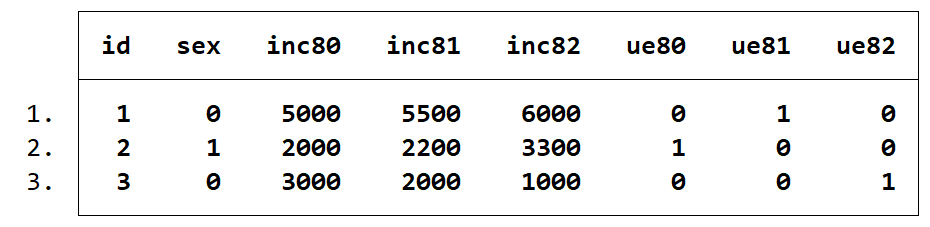
Trong đó:
- id xác định từng cá nhân
- inc80 inc81 inc82 là thu nhập trong các năm 1980, 1981 và 1982
- ue80 ue81 ue82 là tình trạng thất nghiệp tương ứng theo năm
Trong dữ liệu này, các biến inc và ue chứa thông tin của cùng một id qua các năm khác nhau.
Để chuyển từ wide sang long:
reshape long inc ue, i(id) j(year)
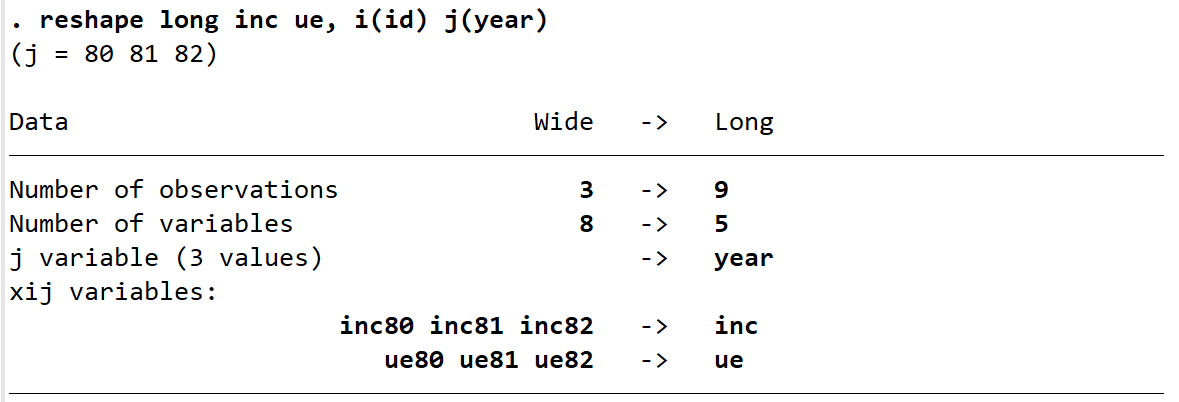
Trong đó:
- inc và ue là các stub (tên chung);
- i(id) xác định đơn vị chính;
- j(year) yêu cầu Stata tạo biến year từ các hậu tố 80, 81, 82.
Xem kết quả:
list, sepby(id)
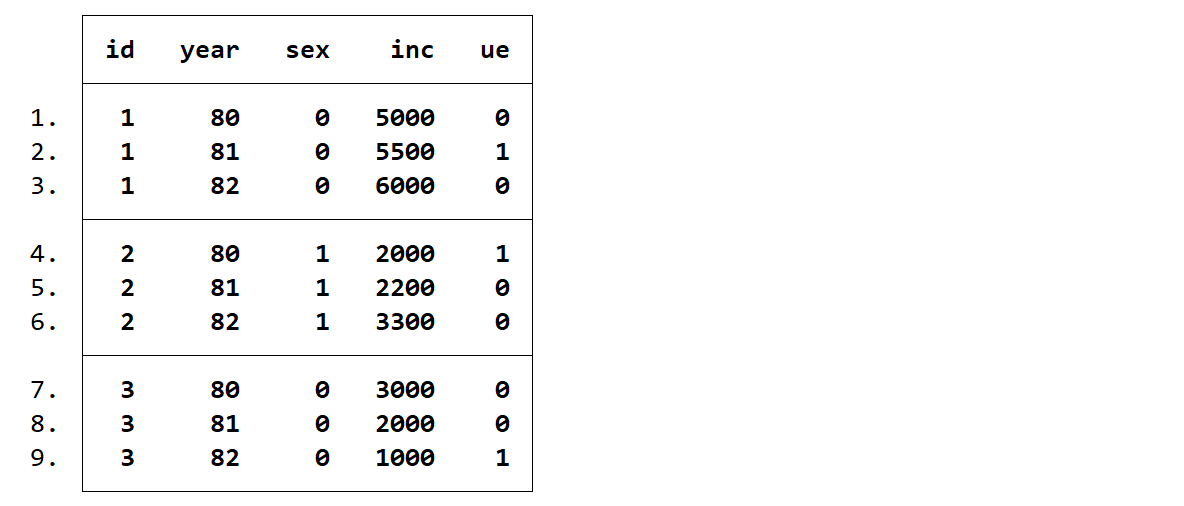
Có thể trở lại wide bằng:
reshape wide
Stata nhớ cấu trúc reshape trước đó, nên trong trường hợp này không nhất thiết phải khai báo lại toàn bộ biến.
Nếu muốn viết đầy đủ:
reshape wide inc ue, i(id) j(year)
3. Ba thành phần quan trọng của reshape
Một lệnh như:
reshape long inc ue, i(id) j(year)
có ba thành phần chính cần ghi nhớ.
- i() xác định đơn vị quan sát chính (như cá nhân, hộ gia đình, công ty, quốc gia). Trong ví dụ trên, thì i(id) nghĩa là id xác định cá nhân.
- j() xác định các quan sát lặp lại bên trong mỗi i() thường là thời gian tháng, quý, năm. Trong ví dụ trên, j(year) nghĩa là mỗi id có nhiều quan sát theo năm.
- Stub là phần chung trong tên của một nhóm biến. Trong ví dụ trên, inc80, inc81, inc82 có Stub là inc, và ue80, ue81, ue81 có Stub là ue.
Vì vậy chúng ta sử dụng:
reshape long inc ue, i(id) j(year)
Có thể nhớ theo logic:
- i() = ai hoặc đơn vị nào?
- j() = lặp lại theo cái gì?
- stub = biến nào đang được trải rộng hoặc thu lại?
4. Ví dụ 2 – lỗi khi biến trong i() không xác định duy nhất quan sát
Mở dữ liệu:
webuse reshape2, clear
Xem dữ liệu:
list
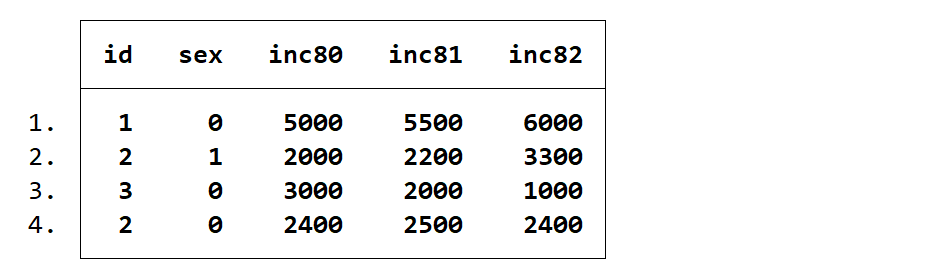
Kiểm tra xem id có bị trùng không:
duplicates report id
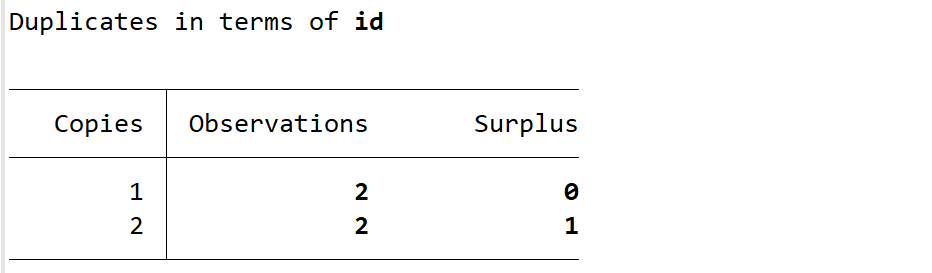
Kết quả là có (bạn có thể thử lệnh này cho Ví dụ 1 ở trên để so sánh). Cho nên reshape sẽ bị báo lỗi. Thử nhé.
capture noisily reshape long inc, i(id) j(year)
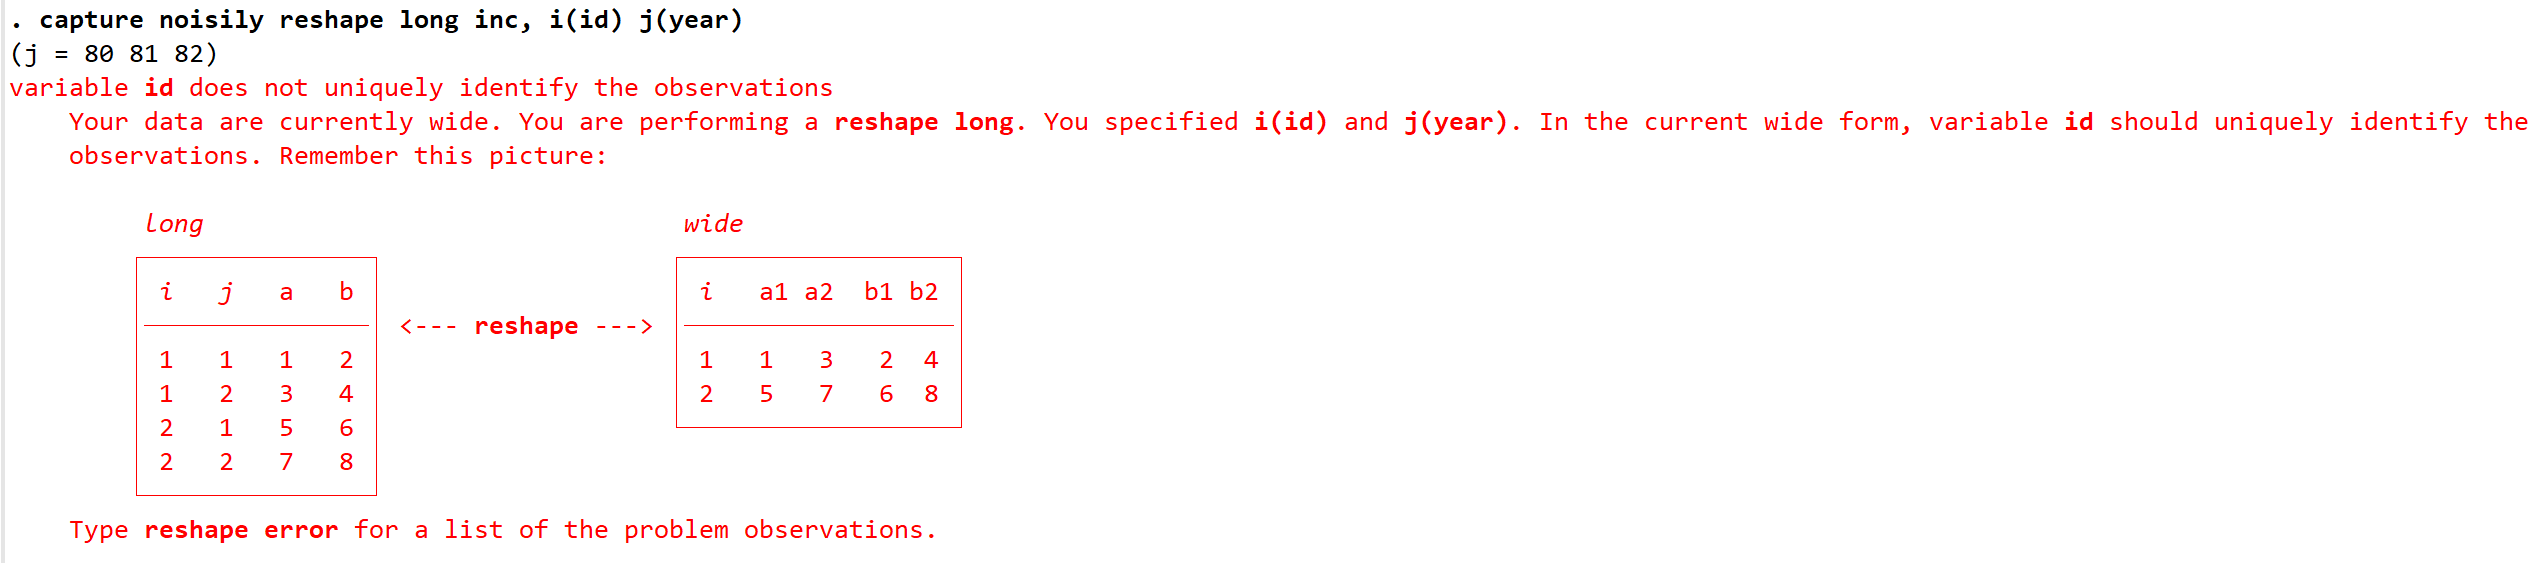
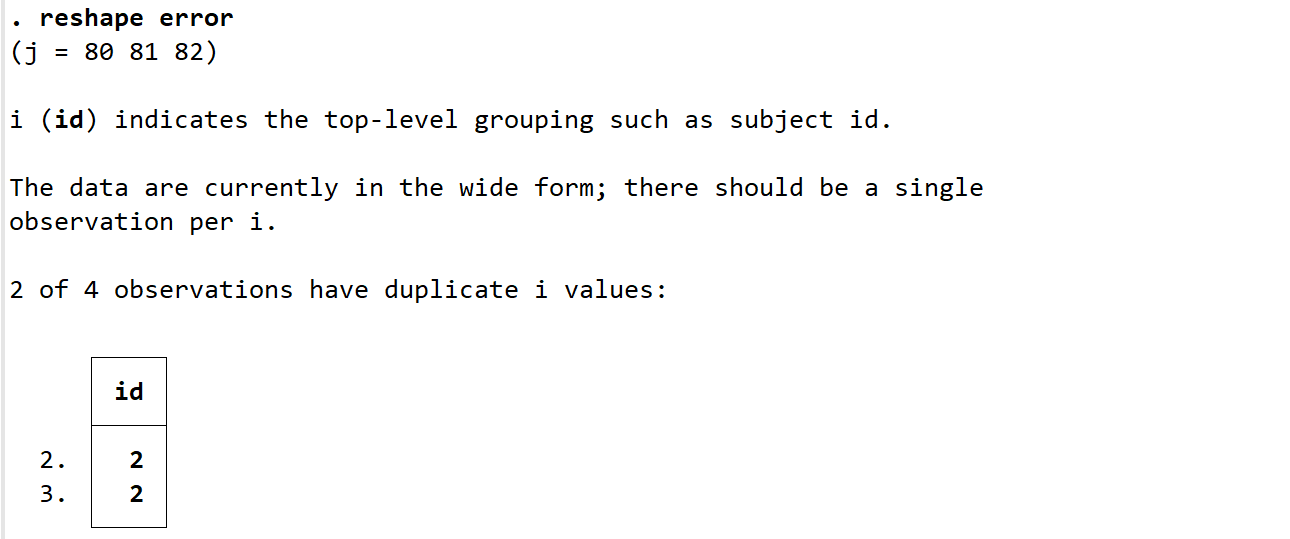
Trong ví dụ này, Stata sẽ báo lỗi vì id không xác định duy nhất các quan sát trong dữ liệu wide.
Có thể xem thêm thông tin:
reshape error
Bài học quan trọng là:
Trước khi reshape, phải kiểm tra biến trong i() và j() có đủ để xác định đúng cấu trúc dữ liệu hay không.
Điều này đặc biệt quan trọng khi làm việc với VHLSS.
5. Ví dụ 3 – vị trí của j() trong tên biến
Lưu ý: Không phải lúc nào phần xác định j() cũng nằm ở cuối tên biến.
Mở dữ liệu:
webuse reshape3, clear
Xem dữ liệu:
list
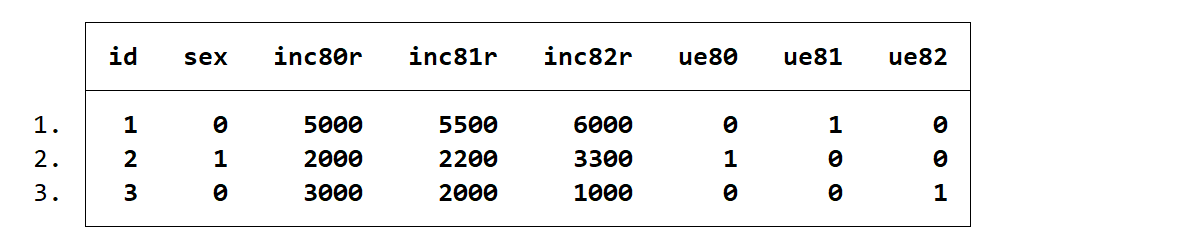
Ta thấy trong các biến inc đều có chữ r ở cuối. Chữ r nghĩa là ‘real’. Vậy ta thực hiện reshape như sau:
reshape long inc@r ue, i(id) j(year)
Dấu @ cho Stata biết vị trí của phần j() trong tên biến.
Xem kết quả:
list, sepby(id)
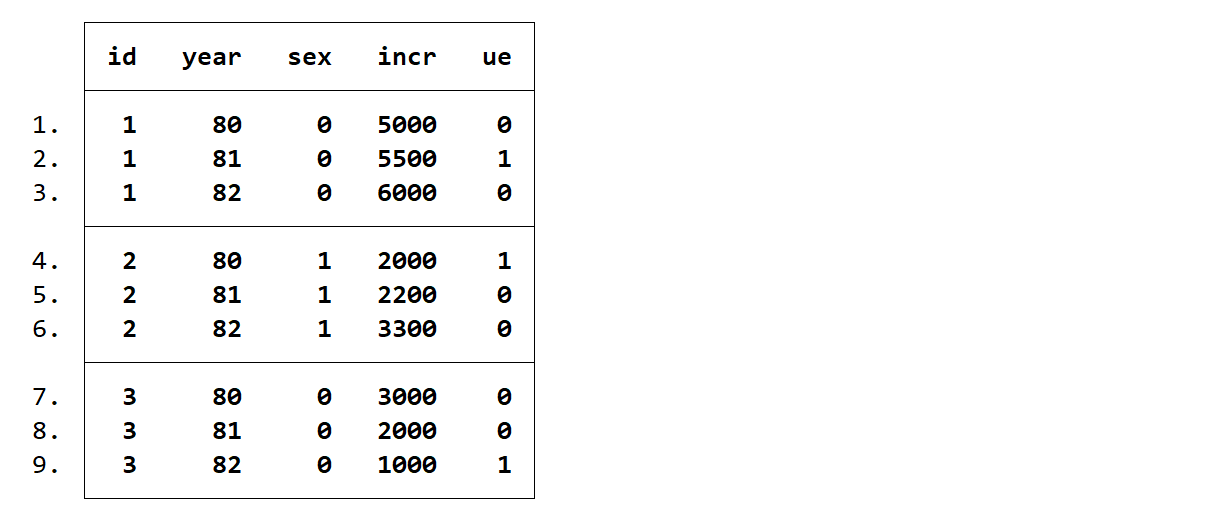
Có thể quay lại wide:
reshape wide
Hoặc
reshape wide inc@r ue, i(id) j(year)
Ví dụ này giúp bạn hiểu rằng cách đặt tên biến đôi khi phức tạp hơn dạng đơn giản inc80, inc81, inc82.
6. Ví dụ 4 – khi j() là biến chuỗi
Mở dữ liệu:
webuse reshape4, clear
Xem dữ liệu:
list
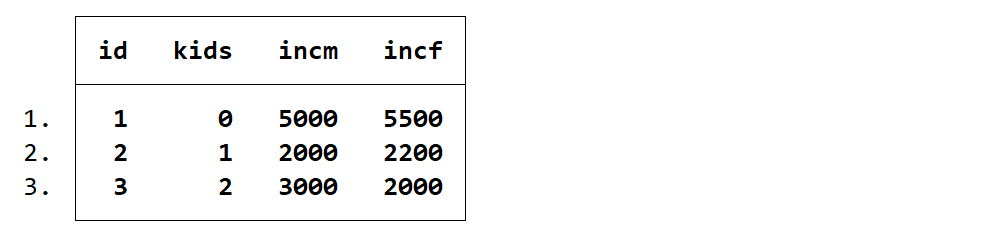
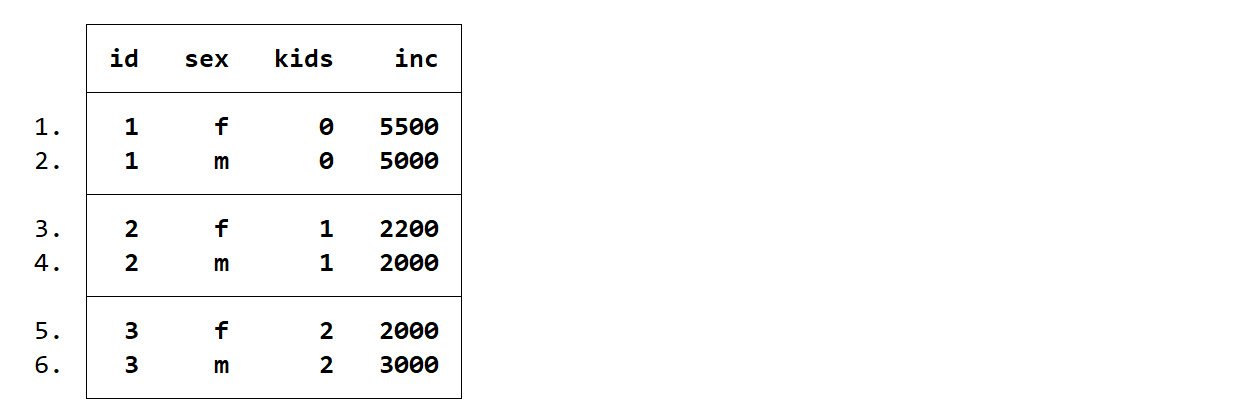
Trong ví dụ này, phần j() là chuỗi – m và f chứ không phải số. Các chữ m và f đại diện cho male và female, được gán sau Stub là inc. Vì vậy cần thêm option string:
reshape long inc, i(id) j(sex) string
Xem kết quả:
list, sepby(id)
Quay lại wide:
reshape wide
Hoặc
reshape wide inc, i(id) j(sex) string
Điểm cần nhớ:
Nếu giá trị dùng cho j() là chữ như male, female, m, f,… thì thường cần option string.
7. Ví dụ 5 – reshape qua nhiều cấp
Mở dữ liệu:
webuse reshape5, clear
Xem dữ liệu:
list
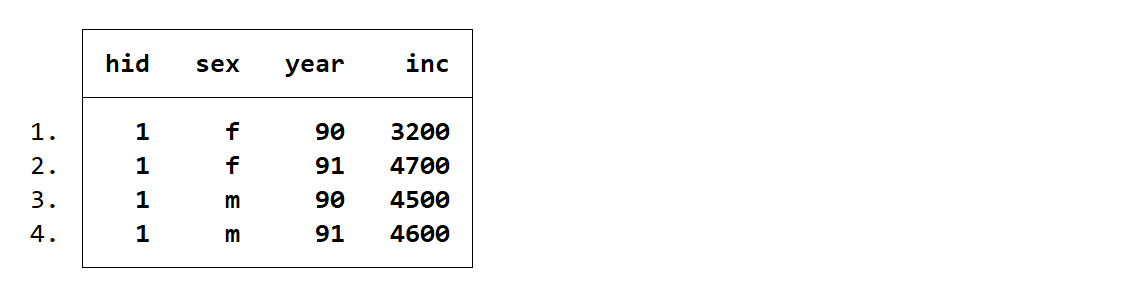
Trước tiên chuyển giới tính từ long sang wide:
reshape wide @inc, i(hid year) j(sex) string
Xem kết quả:
list
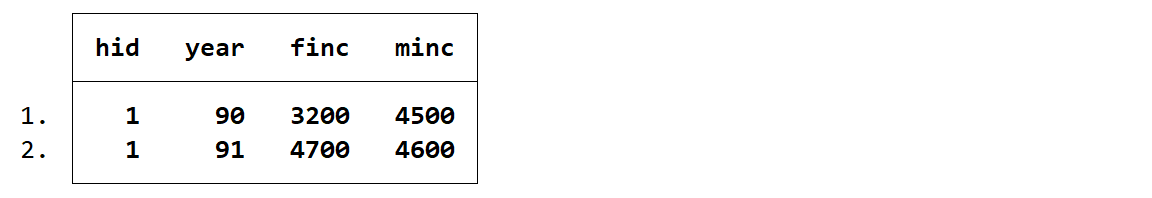
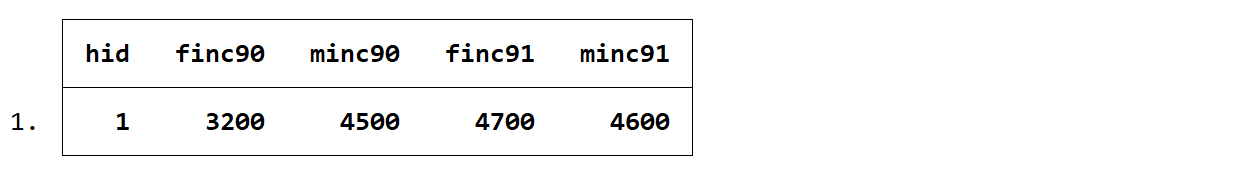
Tiếp tục chuyển năm từ long sang wide:
reshape wide minc finc, i(hid) j(year)
Lúc này mỗi hid chỉ còn một dòng.
Xem kết quả:
list
Có thể thực hiện ngược lại:
reshape long minc finc, i(hid) j(year)
list, sepby(hid)
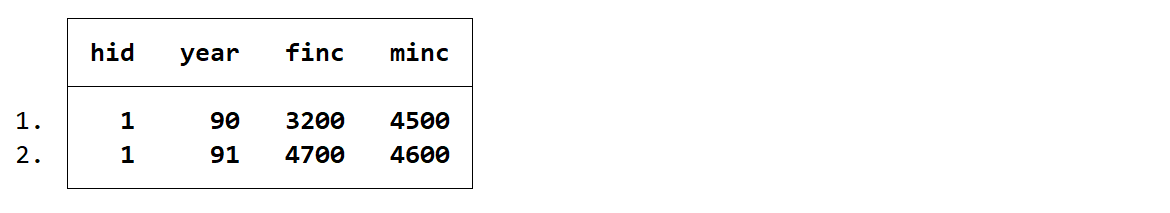
Sau đó:
reshape long @inc, i(hid year) j(sex) string
list, sepby(hid)
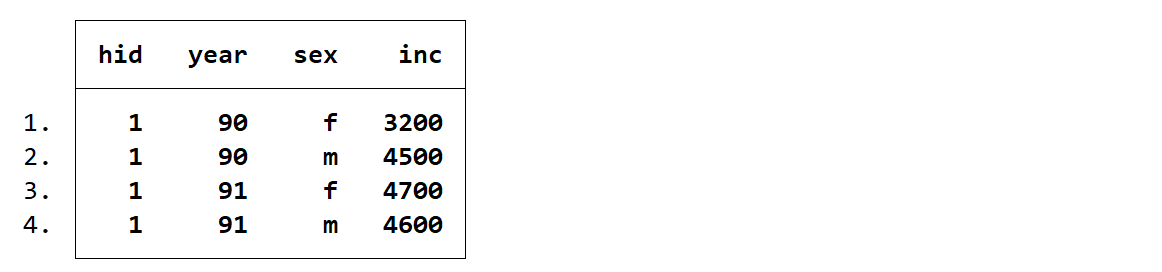
Ví dụ này cho thấy một bộ dữ liệu có thể được reshape qua nhiều bước, tùy theo cấp độ mà chúng ta muốn phân tích.
8. Tóm tắt trước khi chuyển sang VHLSS
Có thể ghi nhớ:
- reshape long → chuyển cột thành dòng
- reshape wide → chuyển dòng thành cột
Và
- i() → đơn vị quan sát chính
- j() → biến xác định các quan sát bên trong mỗi đơn vị
- stub → phần chung của tên biến
Ví dụ trong VHLSS ta có thể thấy dữ liệu như sau:
Dạng long (theo thành viên trong hộ)
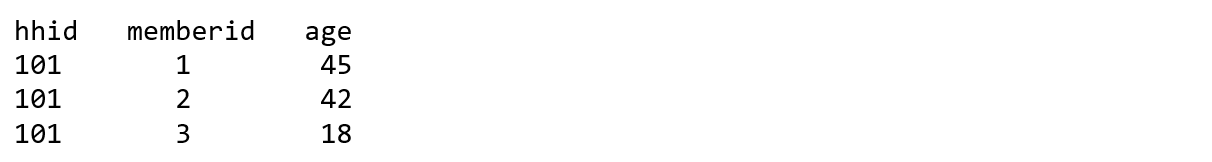
Nếu chạy:
reshape wide age, i(hhid) j(memberid)
ta sẽ có:

Đây chính là logic chúng ta sẽ áp dụng cho VHLSS trong bài hướng dẫn này. Bắt đầu thôi!
9. Mở dữ liệu VHLSS 2020
Thiết lập thư mục:
cd “D:\vhlss\vhlss20”
Mở dữ liệu:
use muc1a.dta, clear
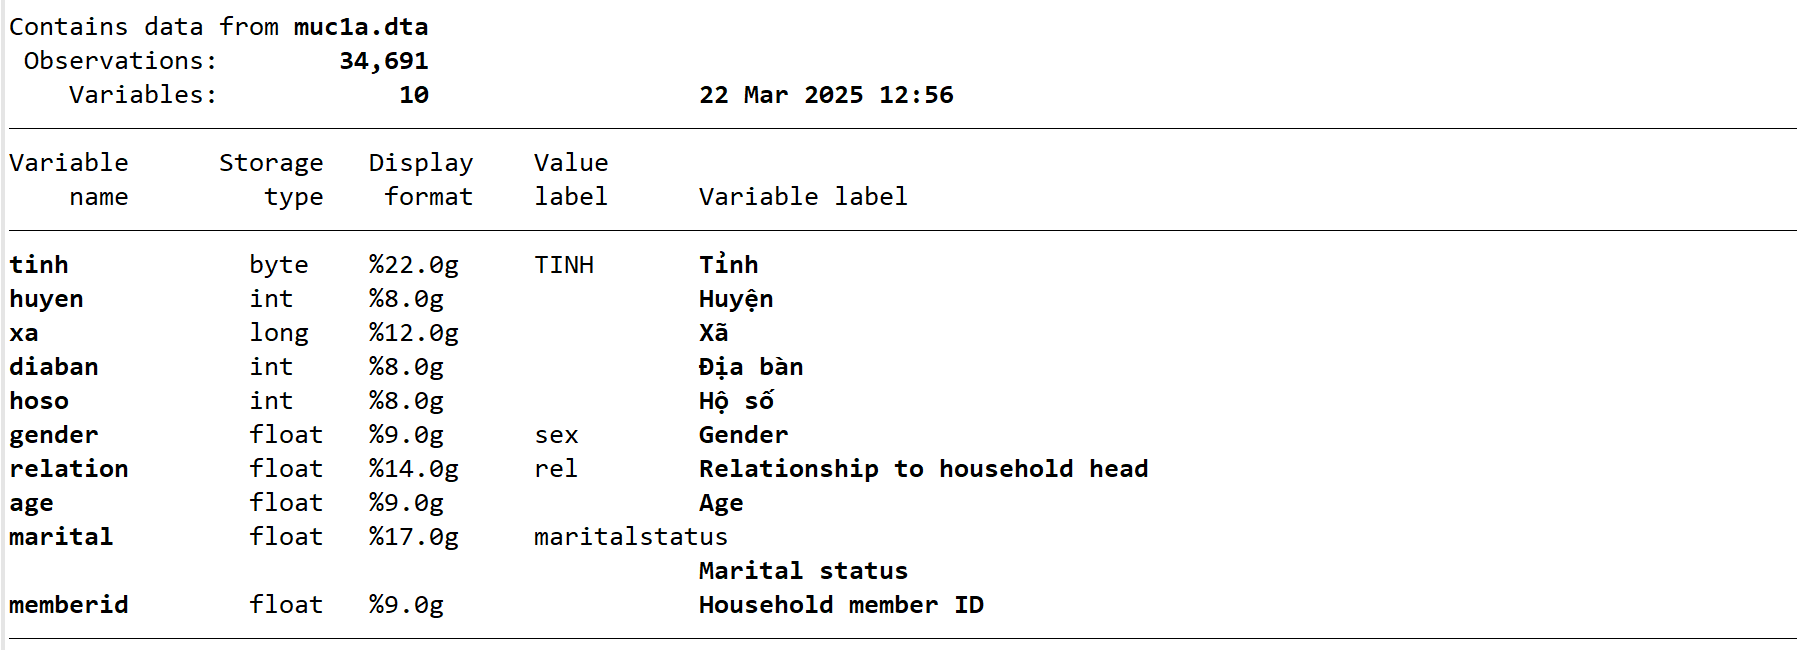
Kiểm tra:
des
Hoặc list in 1/20
Trong muc1a.dta, mỗi dòng là một thành viên hộ. Vì vậy, đây là dữ liệu dạng long theo thành viên.
10. Tạo các biến có tên dễ hiểu
Tiếp tục sử dụng cách đặt tên của Bài 4:
gen gender = m1ac2
gen relation = m1ac3
gen age = m1ac5
gen marital = m1ac8
gen memberid = m1ama
Đặt variable labels:
label variable gender “Gender”
label variable relation “Relationship to household head”
label variable age “Age”
label variable marital “Marital status”
label variable memberid “Household member ID”
11. Tạo lại value labels
Nếu value labels gốc bị lỗi font, có thể tạo lại bằng tiếng Anh (giả sử bạn làm nghiên cứu bằng tiếng Anh).
Giới tính:
label define sex 1 “Male” 2 “Female”, replace
label values gender sex
Quan hệ với chủ hộ:
label define rel 1 “Household head” 2 “Spouse” 3 “Child” 4 “Parent” 5 “Grandparent” ///
6 “Grandchild” 7 “Other”, replace
label values relation rel
Tình trạng hôn nhân:
label define maritalstatus 1 “Never married” 2 “Currently married” 3 “Widowed” ///
4 “Divorced” 5 “Separated”, replace
label values marital maritalstatus
12. Giữ các biến cần thiết
keep tinh huyen xa diaban hoso memberid gender relation age marital
des
13. Tạo mã định danh hộ và cá nhân
Tạo hhid:
egen hhid = group(tinh huyen xa diaban hoso)
label variable hhid “Household ID”
Kiểm tra tổ hợp hộ và thành viên:
isid hhid memberid
Nếu Stata không báo lỗi (và thực sự là không báo lỗi), thì mỗi thành viên được xác định duy nhất bởi:
hhid + memberid
Tiếp theo, tạo pid:
egen pid = group(hhid memberid)
label variable pid “Person ID”
Kiểm tra:
isid pid
14. Xác định chủ hộ
Theo bảng câu hỏi:
relation = 1 → Household head
Do đó:
gen hhhead = (relation == 1)
label variable hhhead “Household head”
Kiểm tra:
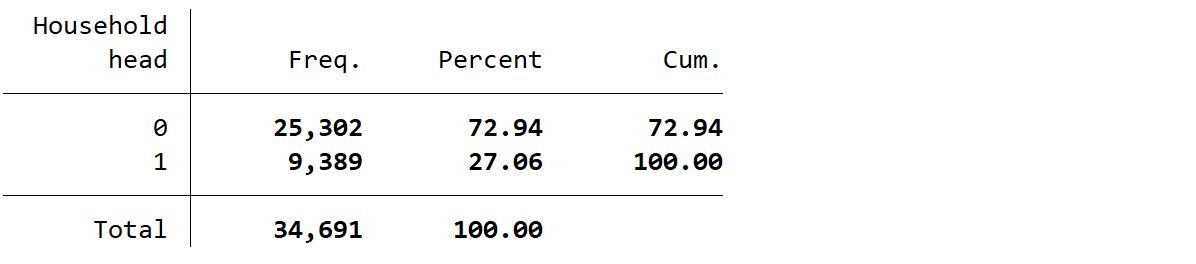
tab hhhead
Một hộ về nguyên tắc phải có đúng một chủ hộ. Vì vậy:
bysort hhid: egen nhead = total(hhhead)
tab nhead
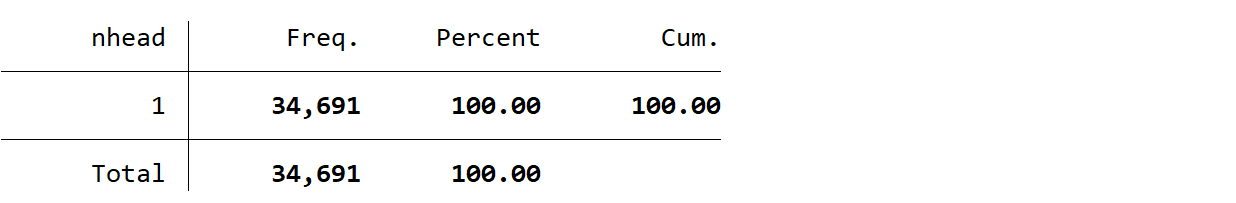
Giả sử mỗi hộ có đúng 1 chủ hộ, thì nhead = 1 được gán cho tất cả thành viên trong hộ đó. Cho nên nhead bằng tổng số thành viên trong bộ dữ liệu.
Nếu mọi hộ đều có đúng một chủ hộ:
Lệnh assert ở đây đóng vai trò rất quan trọng: nó kiểm tra một giả định về cấu trúc dữ liệu trước khi chúng ta tiếp tục xử lý.
Bây giờ ta nên:
drop nhead
15. Tạo lại một số biến cấp hộ từ Bài 4
Tạo quy mô hộ:
bysort hhid: gen hhsize = _N
label variable hhsize “Household size”
Tạo biến trẻ em:
gen child = (age < 15)
Tạo biến người cao tuổi:
gen elderly = (age >= 60)
Tính số trẻ em:
bysort hhid: egen nchild = total(child)
label variable nchild “Number of children under 15”
Tính số người cao tuổi:
bysort hhid: egen nelderly = total(elderly)
label variable nelderly “Number of persons aged 60 or over”
Kiểm tra:
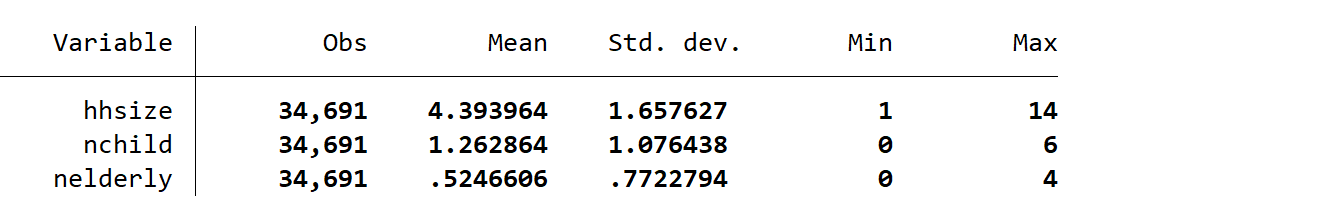
sum hhsize nchild nelderly
Các biến này sẽ được giữ lại sau khi chuyển dữ liệu sang cấp hộ.
16. Xem dữ liệu trước khi reshape
Sắp xếp:
sort hhid memberid
Xem một số hộ:
list hhid pid memberid gender relation age marital hhsize in 1/19, sepby(hhid)
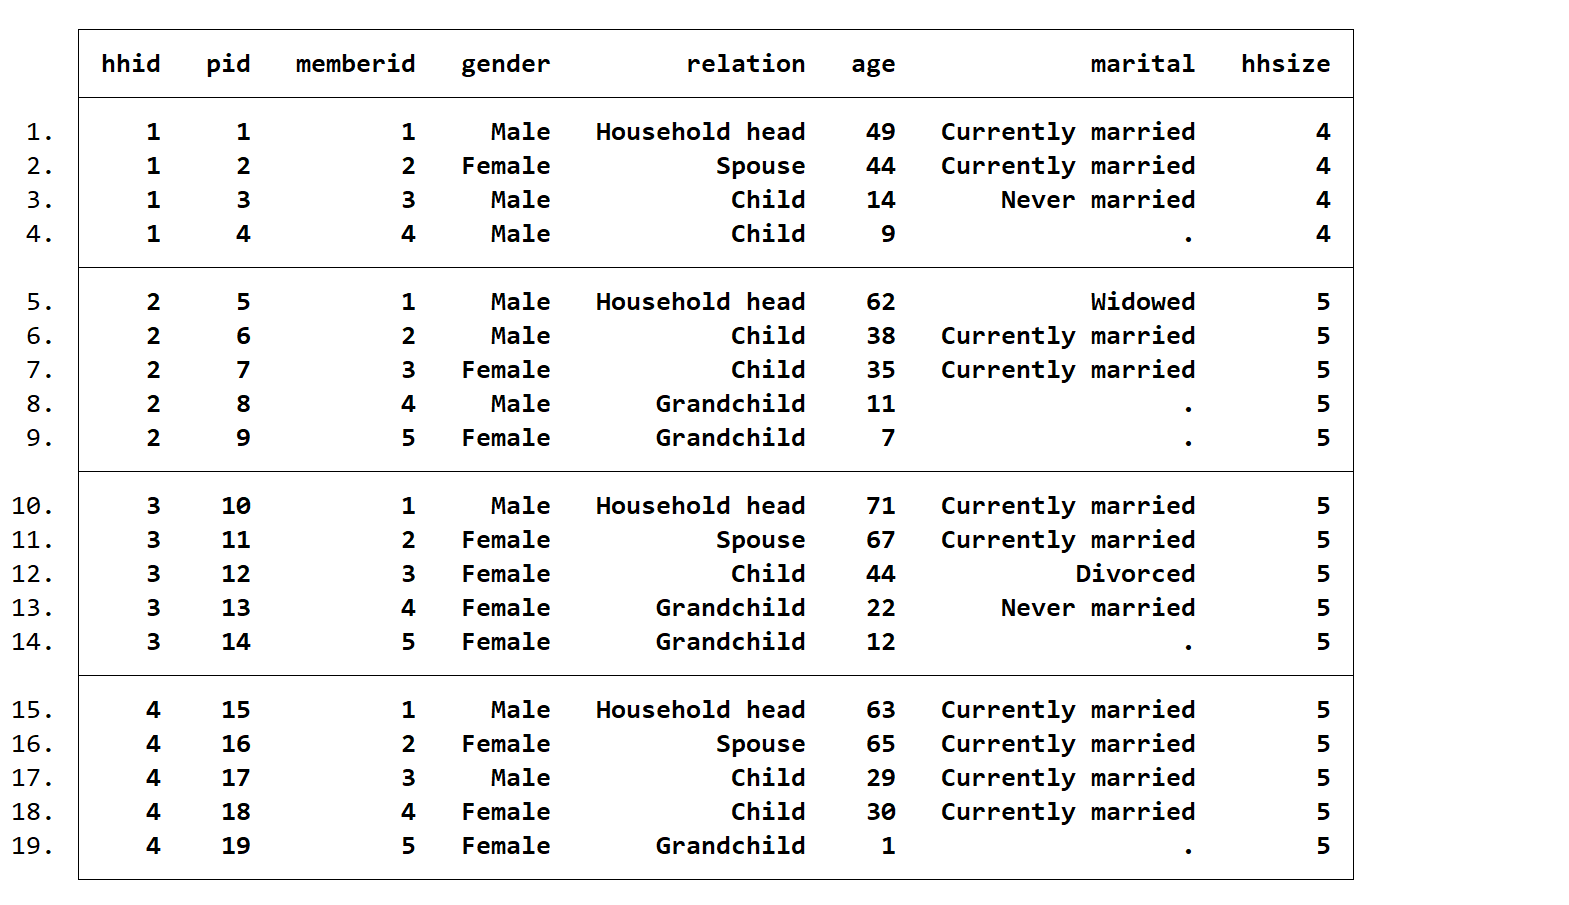
Ta thấy một hhid xuất hiện nhiều lần, tương ứng với số thành viên của hộ. Và rõ ràng dữ liệu này đang ở dạng long theo thành viên.
17. Kiểm tra cấu trúc trước khi reshape
Trước khi reshape, kiểm tra:
isid hhid memberid
Nhớ lại rằng lệnh này rất quan trọng vì trong lệnh reshape sắp tới với:
- i() = hhid
- j() = memberid
Mỗi memberid phải xuất hiện duy nhất trong từng hhid.
Ta cũng có thể xác định mã thành viên lớn nhất:
quietly summarize memberid, meanonly
local maxmember = r(max)
Hiển thị:
display “Maximum household member ID = `maxmember'”
Local macro maxmember sẽ được sử dụng sau này để tìm chủ hộ trong các biến wide.
18. Reshape dữ liệu thành viên từ long sang wide
Một việc quan trọng là chỉ giữ các biến cần thiết trước khi reshape. Không giữ pid vì pid thay đổi theo từng thành viên, trong khi sau reshape mỗi dòng sẽ là một hộ; memberid đã được dùng làm biến j() để phân biệt thành viên.
Chính vì thế, ta cần:
keep hhid tinh huyen xa diaban hoso memberid gender relation age marital ///
hhsize nchild nelderly
Bây giờ chúng ta có thể thực hiện:
reshape wide gender relation age marital, i(hhid) j(memberid)
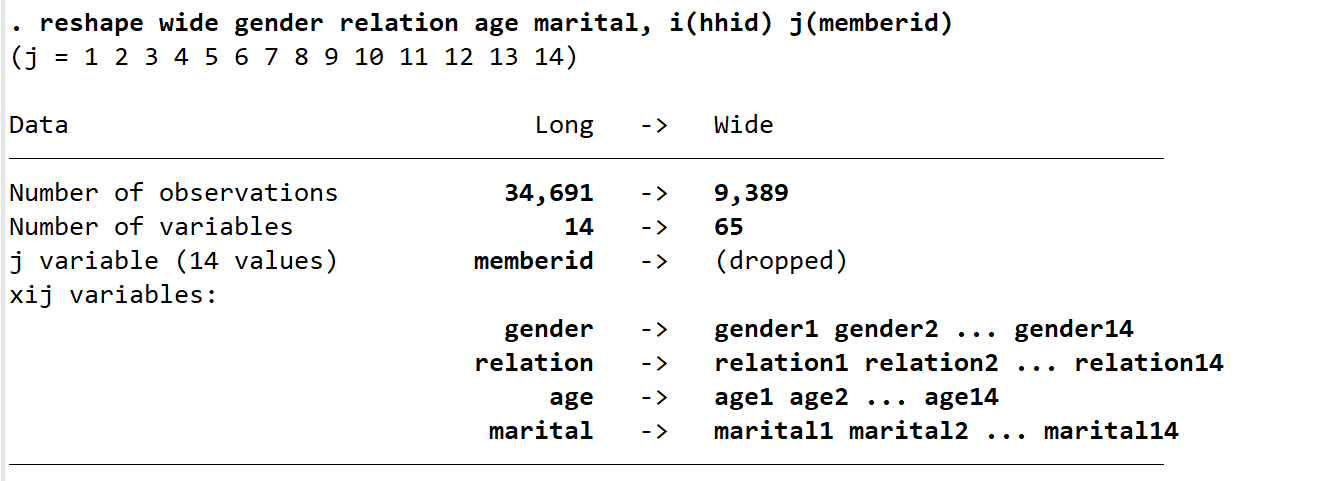
Ta nên xem kết quả bằng cách mở Data editor:
edit
Như vậy:
- Trước reshape: một dòng = một thành viên.
- Sau reshape: một dòng = một hộ.
Kiểm tra:
isid hhid
Thấy Stata không báo lỗi, cho nên mỗi hộ hiện chỉ xuất hiện một lần.
19. Hiểu tên biến sau khi reshape
Sau reshape ta thấy có nhiều biến hơn (cụ thể là mỗi biến sẽ thành 14 biến vì số thành viên nhiều nhất trong mẫu là 14 người):
gender1
gender2
gender3
…
tương ứng với giới tính của thành viên 1, 2, 3, …
Tương tự:
relation1
relation2
relation2
…
là quan hệ với chủ hộ.
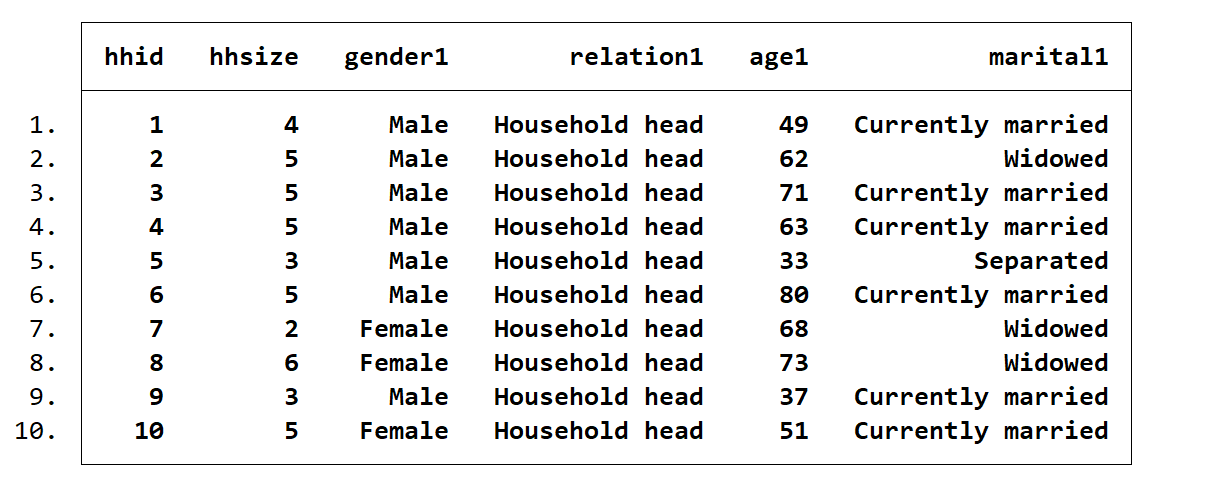
Ta có thể xem các biến tương tứng với thành viên số 1 (tức là chủ hộ) như sau:
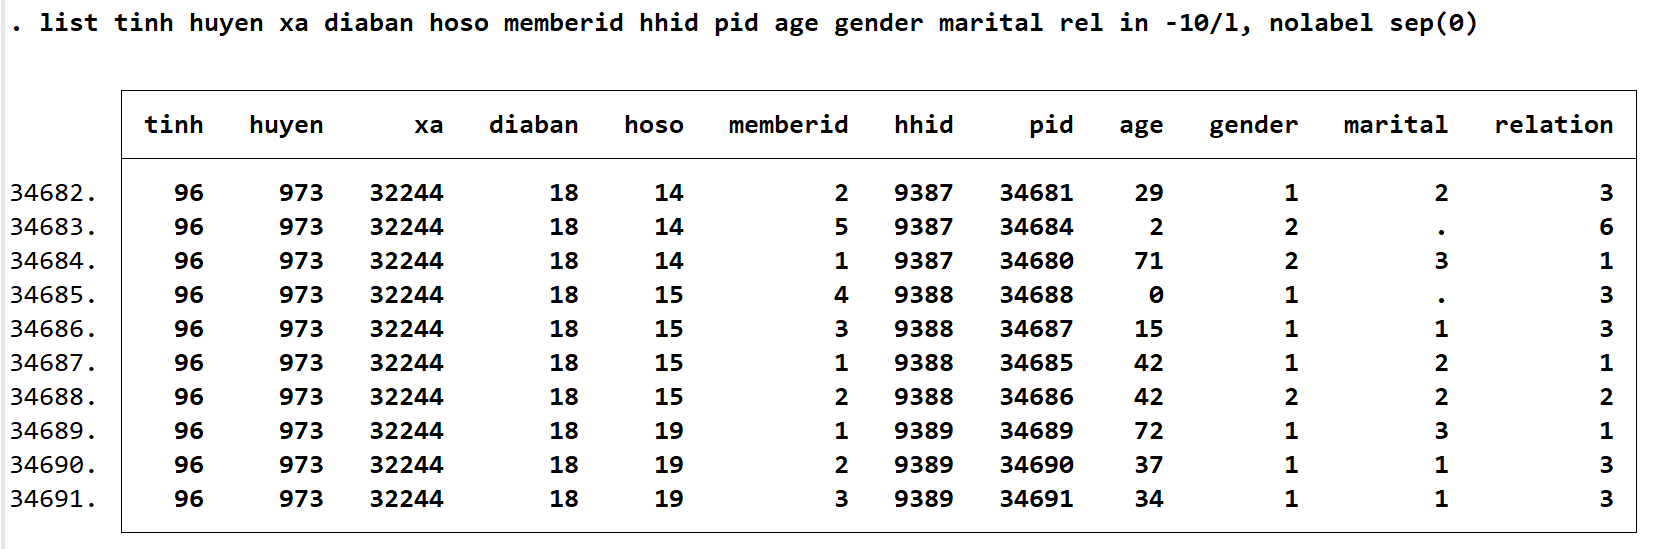
list hhid hhsize gender1 relation1 age1 marital1 in 1/10, sep(0)
20. Tạo các đặc điểm của chủ hộ
Một điểm cần đặc biệt lưu ý:
Không nên mặc định thành viên có memberid == 1 luôn là chủ hộ.
Chúng ta đã có biến relation, trong đó:
relation = 1
xác định chủ hộ. Vì vậy, sau reshape, ta tìm thành viên nào có:
relation1 == 1
relation2 == 1
relation3 == 1
…
Trước tiên tạo các biến rỗng:
gen head_gender = .
gen head_age = .
gen head_marital = .
Sau đó sử dụng vòng lặp:
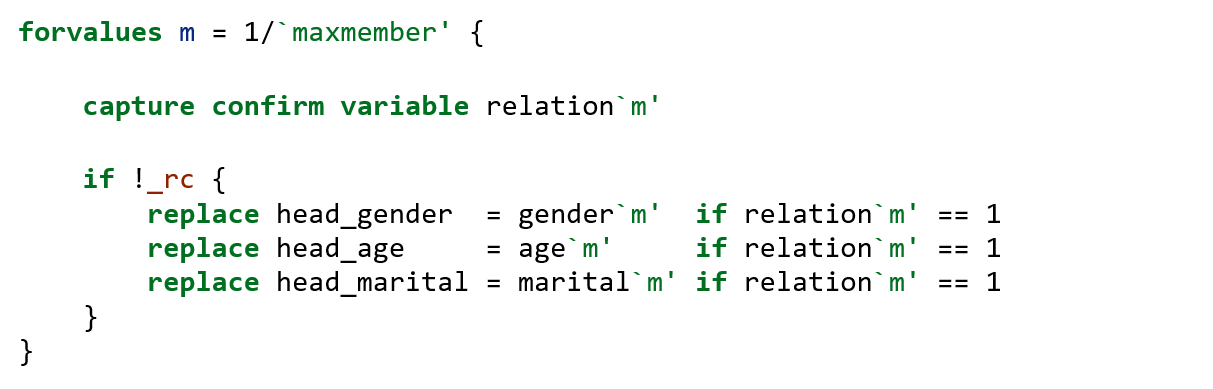
Trong đó:
- forvalues lần lượt xét từng mã thành viên;
- confirm variable kiểm tra biến tương ứng có tồn tại hay không;
- capture ngăn Stata dừng chương trình nếu một biến không tồn tại;
- _rc là return code;
- nếu _rc == 0, biến tồn tại và Stata thực hiện các lệnh replace.
Kết quả là mỗi hộ có:
- head_gender
- head_age
- head_marital
tương ứng với giới tính, tuổi và tình trạng hôn nhân của đúng người được xác định là chủ hộ.
21. Tạo biến giả về đặc điểm của chủ hộ
Tạo biến chủ hộ là nữ:
gen head_female = (head_gender == 2) if !missing(head_gender)
Tạo biến chủ hộ hiện đang có vợ/chồng:
gen head_married = (head_marital == 2) if !missing(head_marital)
Đặt nhãn cho các biến vừa tạo (kể cả biến về chủ hộ):
label variable head_gender “Gender of household head”
label variable head_age “Age of household head”
label variable head_marital “Marital status of household head”
label variable head_female “Female household head”
label variable head_married “Household head currently married”
Gán value labels:
label values head_gender sex
label values head_marital maritalstatus
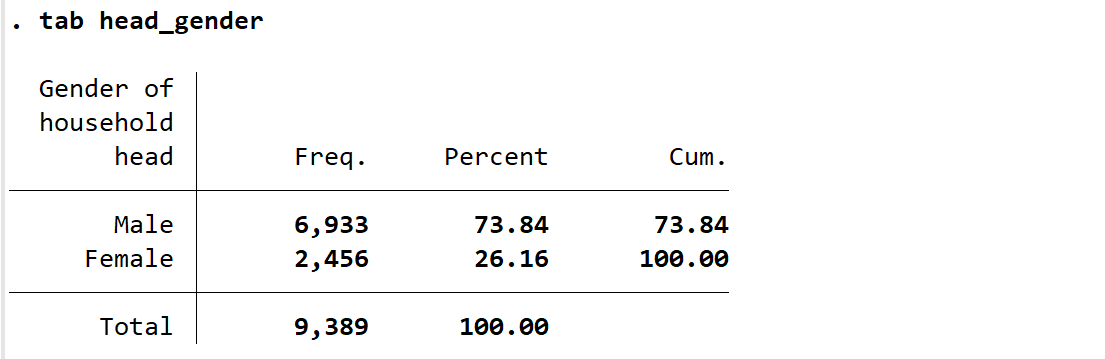
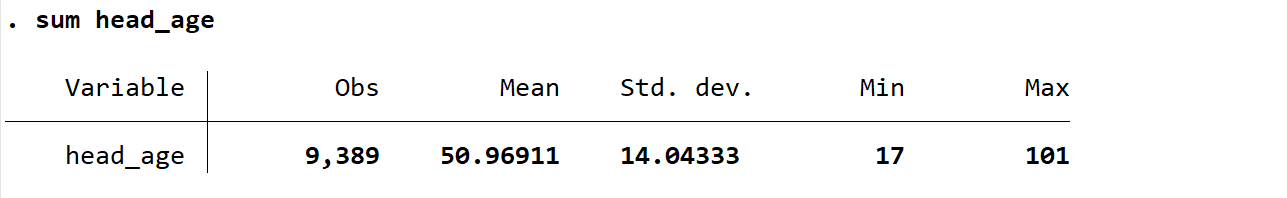
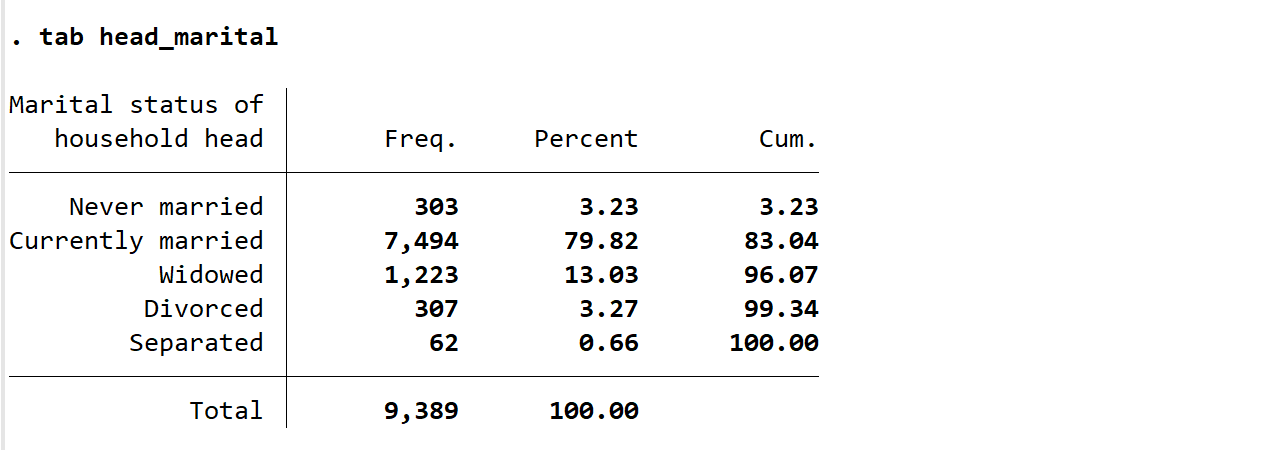
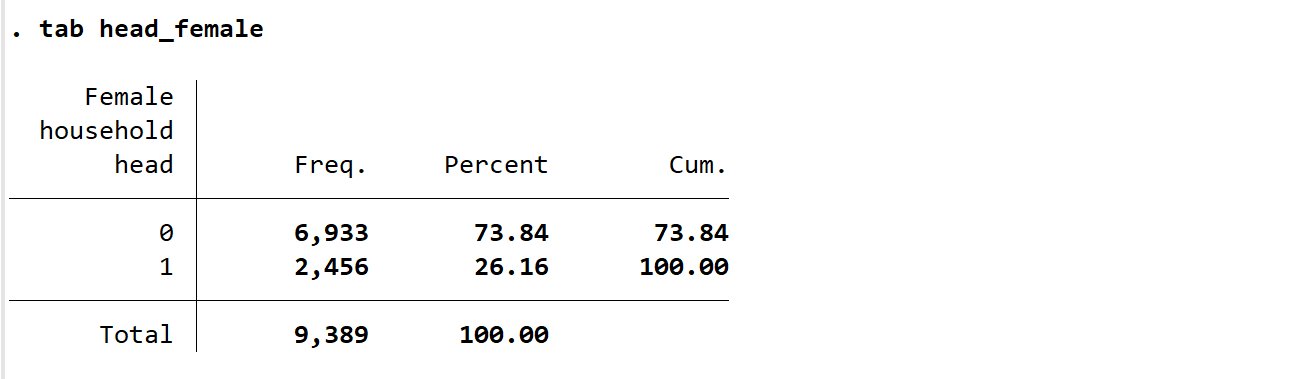
22. Kiểm tra các biến của chủ hộ
Giới tính:
Tuổi:
Tình trạng hôn nhân:
Chủ hộ là nữ:
Chủ hộ đang có vợ/chồng:
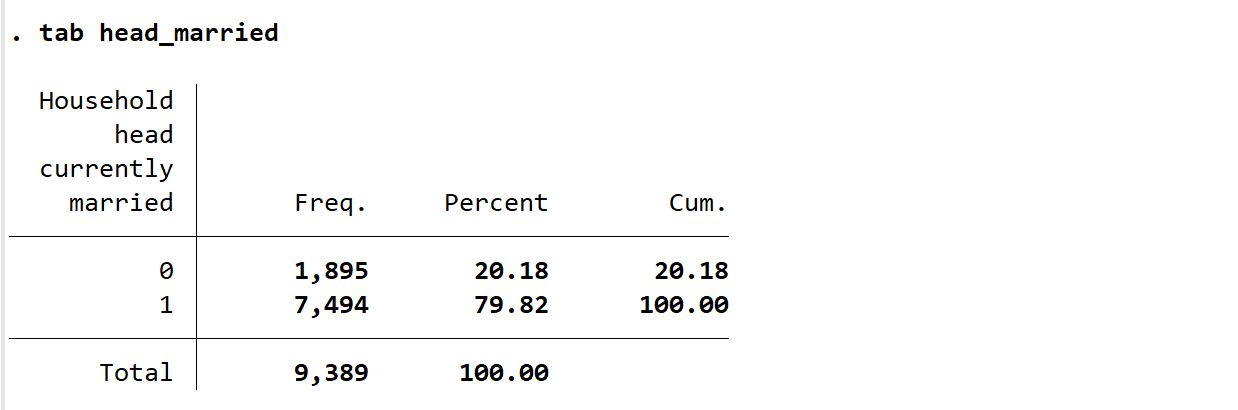
Đây là bước cần thiết sau khi tạo bất kỳ biến mới nào: không nên tạo biến xong rồi tiếp tục ngay mà không kiểm tra kết quả.
23. Kiểm tra missing của các biến chủ hộ
Ta sử dụng các lệnh:
count if missing(head_gender)
count if missing(head_age)
count if missing(head_marital)
Rõ ràng ở bước trước đã xác nhận mỗi hộ có đúng một chủ hộ, các biến này về nguyên tắc không nên bị thiếu.
Có thể kiểm tra:
assert !missing(head_gender)
assert !missing(head_age)
assert !missing(head_marital)
Stata đều không báo lỗi, nên mỗi hộ đã có đầy đủ ba đặc điểm của chủ hộ.
24. Xem dữ liệu cấp hộ
Ta có thể dùng:
list hhid hhsize ///
head_gender head_age head_marital ///
head_female head_married ///
in 1/20, nolabel sep(0)
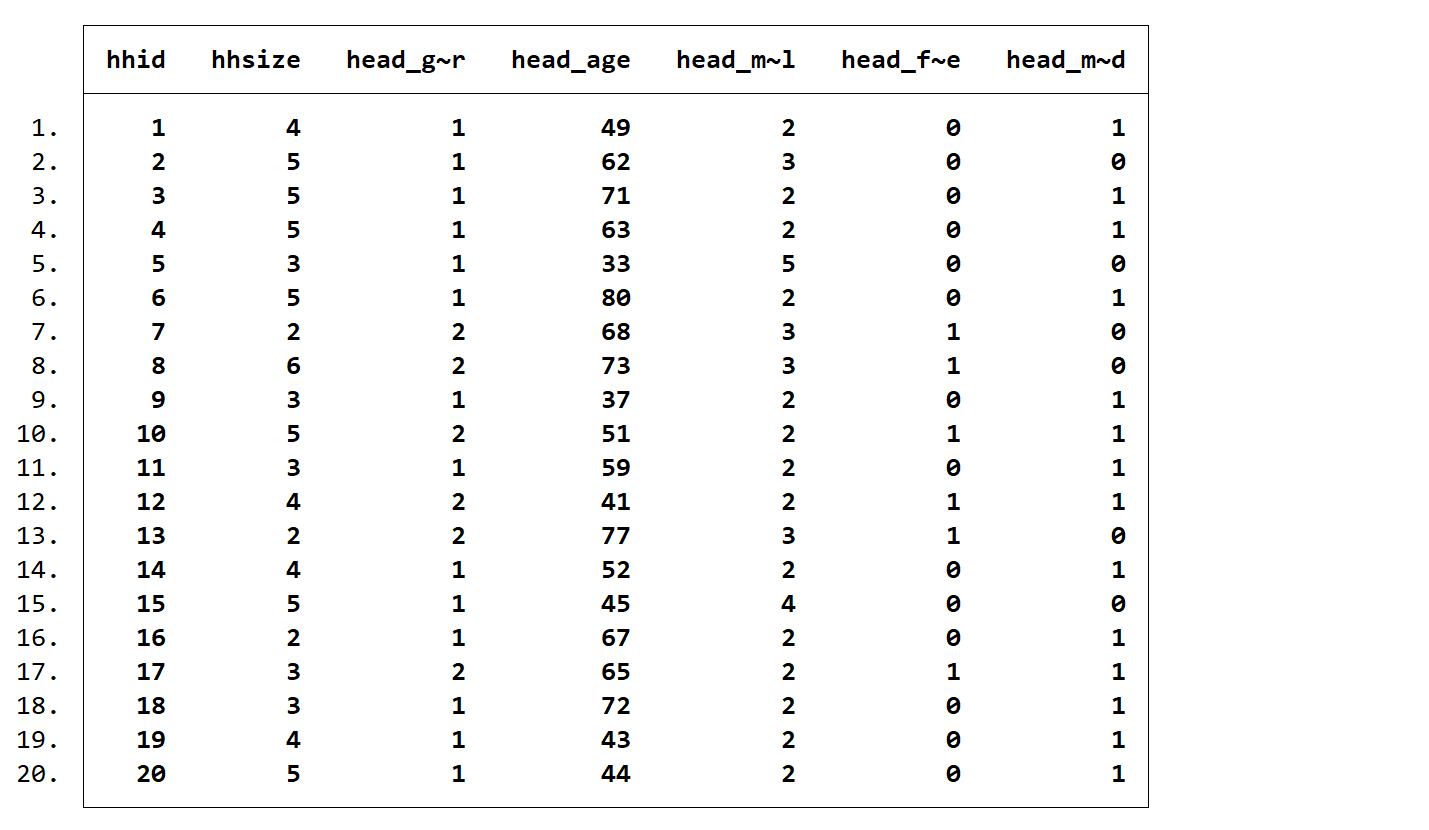
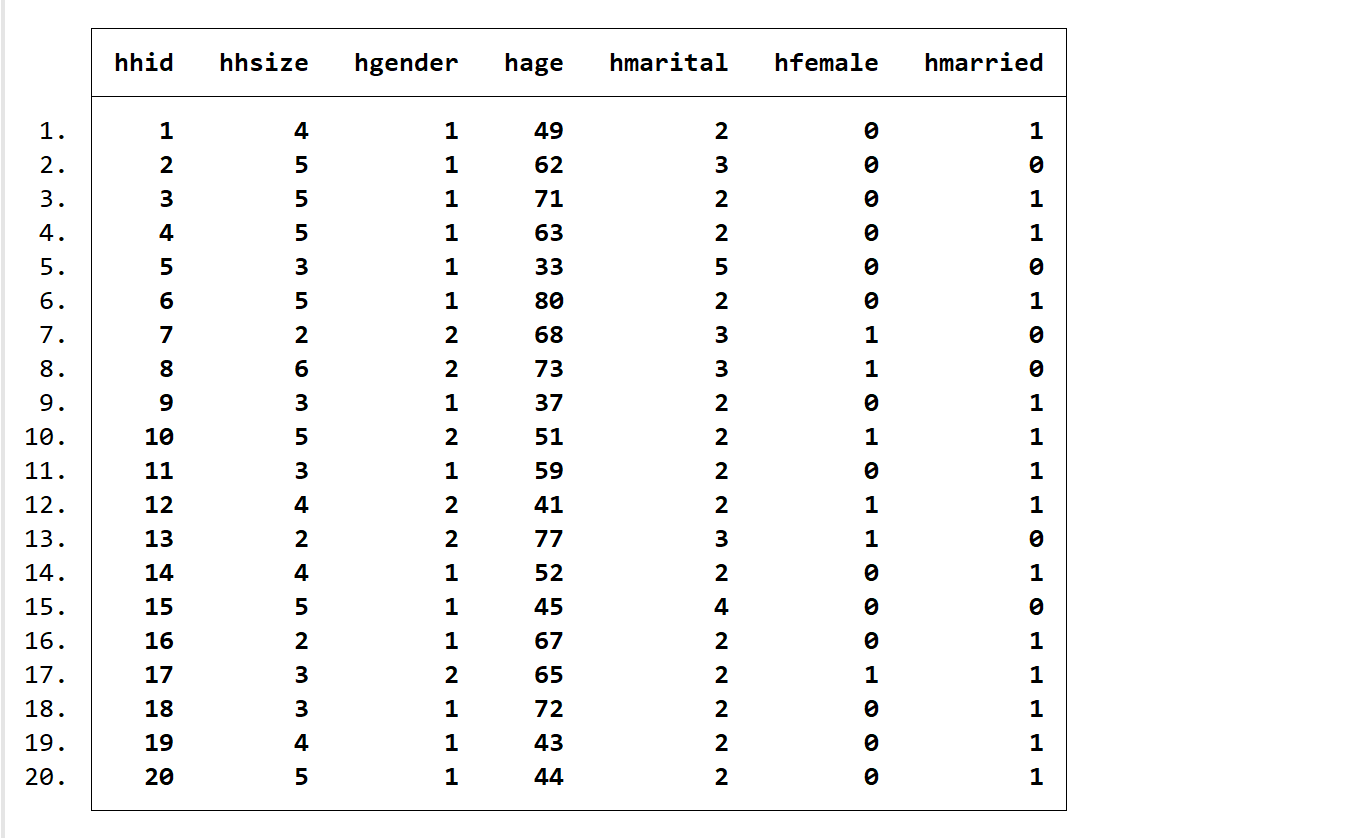
Tên biến quá dài nên bị khuất rồi.
foreach x in gender age marital female married {
rename head_x' hx’
}
list hhid hhsize hgender hage hmarital hfemale hmarried in 1/20, nolabel sep(0)
25. Giữ các biến cần thiết ở cấp hộ
Sau reshape, dữ liệu có thể có rất nhiều biến như:
gender1 gender2 gender3…
relation1 relation2 relation3…
age1 age2 age3…
marital1 marital2 marital3…
Nếu mục tiêu của nghiên cứu chỉ cần đặc điểm của chủ hộ chứ không cần thông tin riêng của từng thành viên, chúng ta có thể giữ lại bộ dữ liệu gọn hơn:
keep hhid ///
tinh huyen xa diaban hoso ///
hhsize nchild nelderly ///
head_gender head_age head_marital ///
head_female head_married
Sắp xếp thứ tự biến:
order hhid ///
tinh huyen xa diaban hoso ///
hhsize nchild nelderly ///
head_gender head_age head_marital ///
head_female head_married
Hoặc hay hơn thì ta dùng các lệnh sau đây:
ds gender* relation* age* marital*
local membervars r(varlist)'
drop membervars’
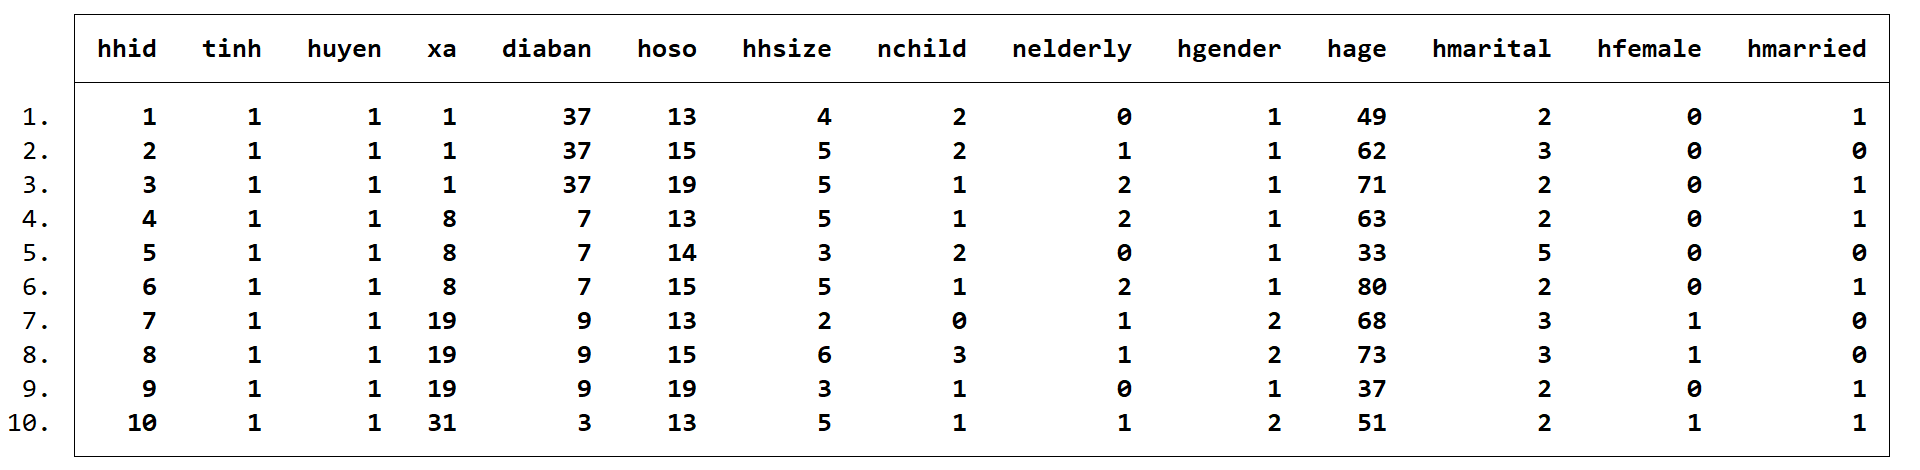
Xem thử nhé:
list in 1/10, nolabel sep(0)
26. Lưu bộ dữ liệu cấp hộ
Trước khi lưu, có thể sử dụng:
compress
compress yêu cầu Stata xem xét lại storage type của các biến và giảm lượng bộ nhớ cần thiết nếu có thể mà không làm mất thông tin.
Sau đó lưu:
save muc1a_household.dta, replace
Bạn có thể lưu với một tên khác!
Tệp dữ liệu mới:
muc1a_household.dta
là bộ dữ liệu cấp hộ được xây dựng từ dữ liệu thành viên trong muc1a.dta và mặc định được lưu trong thư mục “D:\vhlss\vhlss20”.
Lưu ý lần nữa: hhid được tạo bằng egen group() trong tệp hiện tại. Khi merge với các tệp VHLSS khác, không nên tạo hhid độc lập trong từng tệp rồi mặc nhiên cho rằng các mã này sẽ giống nhau. Vì vậy, các biến khóa gốc tinh, huyen, xa, diaban và hoso vẫn được giữ lại để kiểm tra và thực hiện merge một cách an toàn trong các bài tiếp theo.
Lời kết:
Trong bài này, chúng ta đã học một kỹ thuật xử lý dữ liệu quan trọng là reshape. Thông qua năm bộ dữ liệu mẫu của Stata, bạn đã làm quen với sự khác nhau giữa dữ liệu dạng long và wide, hiểu vai trò của i(), j() và stub, biết cách xoay dữ liệu theo cả hai chiều và nhận biết một số tình huống có thể làm reshape báo lỗi.
Sau đó, chúng ta áp dụng trực tiếp kỹ thuật này vào muc1a.dta của VHLSS 2020. Ban đầu, dữ liệu ở cấp thành viên, nghĩa là mỗi dòng tương ứng với một người trong hộ. Sau khi sử dụng reshape wide, mỗi dòng trở thành một hộ và thông tin của các thành viên được chuyển thành các biến riêng biệt. Từ cấu trúc đó, chúng ta sử dụng biến relation để xác định đúng chủ hộ và tạo các đặc điểm quan trọng như head_gender, head_age, head_marital, head_female và head_married.
Điểm quan trọng nhất của bài không phải chỉ là biết cú pháp reshape, mà là hiểu rằng cấu trúc dữ liệu phải phù hợp với đơn vị phân tích. Dữ liệu thành viên phù hợp với những câu hỏi nghiên cứu ở cấp cá nhân, trong khi nhiều nghiên cứu sử dụng VHLSS lại cần một dòng tương ứng với một hộ. Khi đó, việc chuyển đổi cấu trúc dữ liệu và lựa chọn đúng các biến cấp hộ trở thành một bước thiết yếu trước khi phân tích.
Kết thúc Bài 5, chúng ta đã xây dựng được một bộ dữ liệu cấp hộ từ Mục 1A, trong đó có các biến về quy mô hộ, trẻ em, người cao tuổi và đặc điểm của chủ hộ. Đây sẽ là nền tảng để trong các bài tiếp theo chúng ta tiếp tục tạo các biến địa lý, khai thác các mục khác của VHLSS 2020 và từng bước ghép (merge) các nguồn dữ liệu với nhau để xây dựng bộ dữ liệu nghiên cứu hoàn chỉnh.